
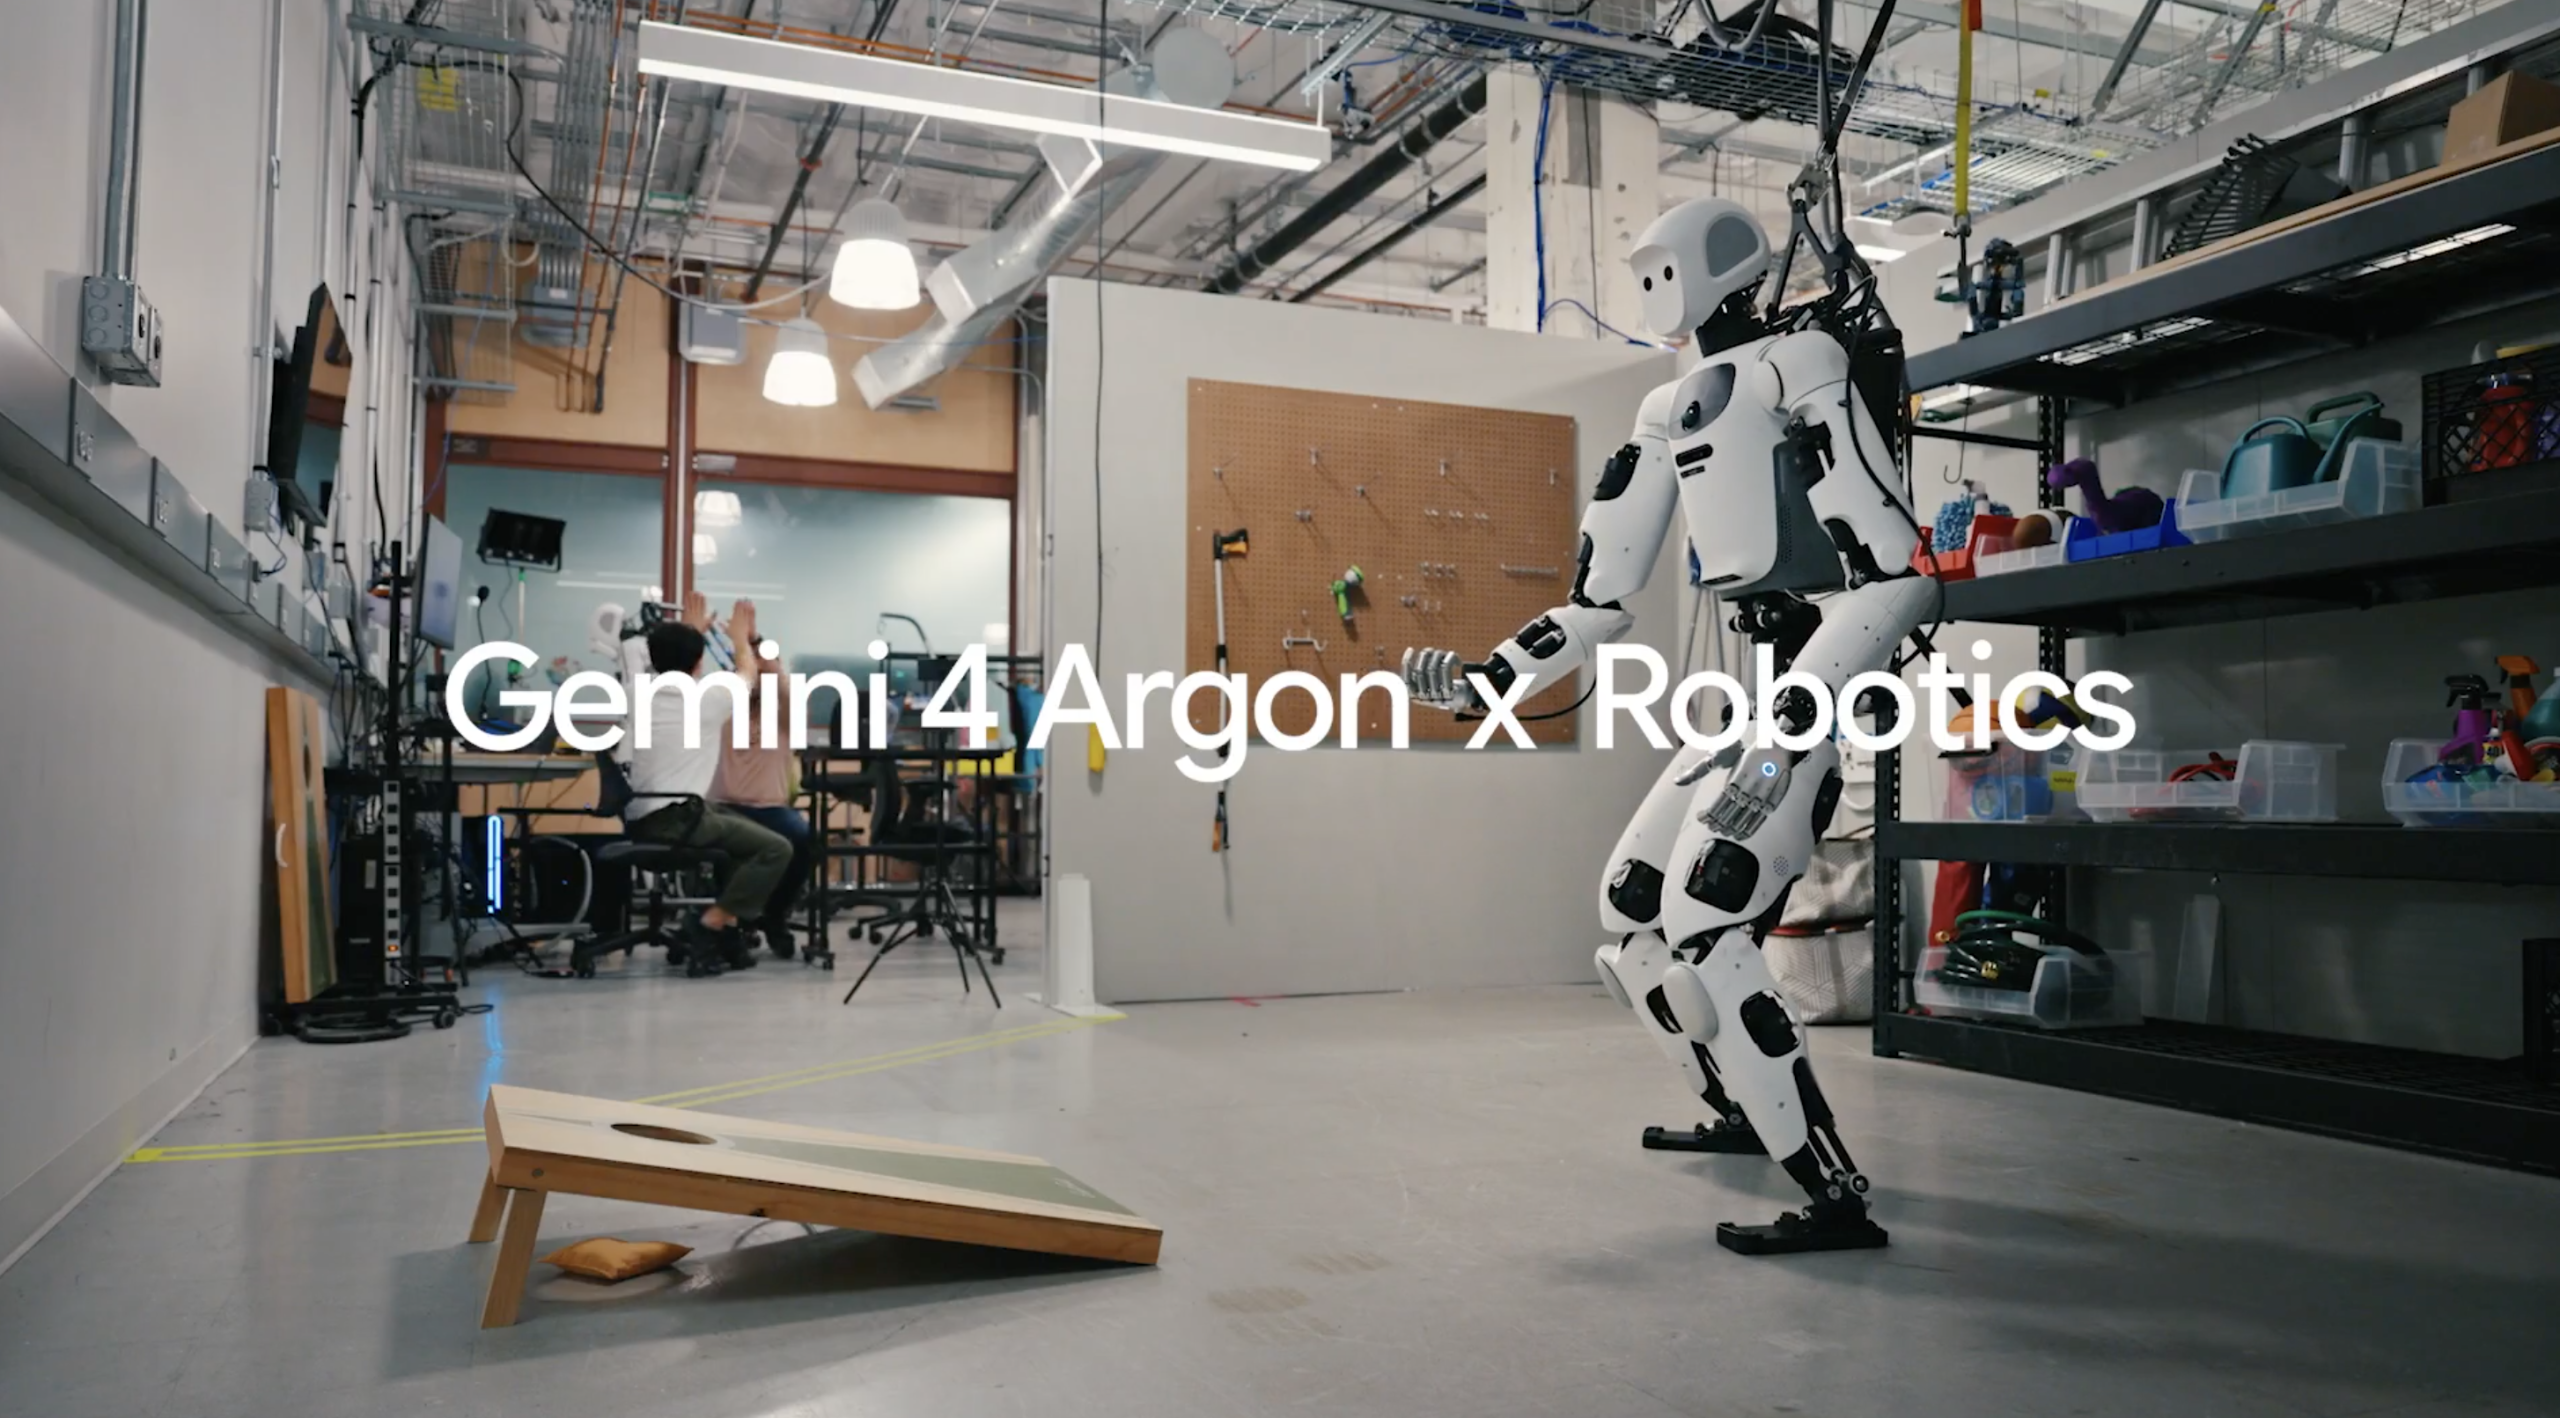
Google 在美國時間 10/13 擴大開放新一代旗艦 AI 模型 Gemini 4 Argon,主打複雜推理、程式開發、企業知識工作與 AI Agent(AI 代理)能力,並宣稱在部分專業任務評測中超越 OpenAI、Anthropic 等競爭對手。
但這次值得關注的不只有模型效能。Google DeepMind 還展示,如何利用 Gemini 4 Argon 分析人類動作影片、自動建立模擬環境,協助 Apptronik 旗下 Apollo 人形機器人學會投擲沙包,並在實機測試中連續命中 7 球。從企業 AI Agent 到實體機器人,Gemini 4 Argon 的能力究竟延伸到了哪一步?
Google 新旗艦模型有多強?企業任務、Agent 成為重點
Google 早在今年 9/30 便首次公布 Gemini 4 Argon,但當時主要開放給經過篩選的資安防禦人員。如今,Google 正式將模型擴大提供給企業、開發者及付費用戶,讓開發者、企業及符合資格的付費用戶,可透過 Gemini API、Google AI Studio、Gemini App,以及 AI 程式開發平台 Antigravity 等服務使用。
Google 將 Gemini 4 Argon 定位為旗下至今最強大的 AI 模型,尤其強調其在複雜推理、程式開發與多步驟任務上的能力。根據 Google DeepMind 公布的模型技術文件,Argon 在衡量金融、法律及程式開發等專業工作能力的第三方 Vals Index 評測中取得 68.9%,超越 Claude Opus 5.5 的 67.0% 和 GPT-6 Astra 的 63.1%;程式開發評測 DeepSWE v1.1 也取得 77.9%。不過,Argon 並非全面領先,例如另一項程式開發測試 FrontierSWE v2,仍落後 GPT-6 Astra。
Google 也開始將模型用於內部工程工作。Google 官方指出,透過 Antigravity 使用 Argon 的團隊,Agent 輔助產生並提交的程式碼量增加超過 35%,程式碼回滾則減少近三分之一。Chrome 團隊更利用它重構大型程式碼庫,將原本需要數月的工作縮短至數週。
價格方面,Argon 的 API 優惠價為每百萬輸入 tokens 2 美元、輸出 tokens 10 美元,12 月起將調整為 4 美元及 20 美元。根據《Reuters》報導,Google 此次將金融、法律、資安與科學研究列為重要應用領域,試圖讓新模型承接更複雜的專業工作。
除了企業工作,Google DeepMind 也開始將 Argon 的視覺理解、物理推理與程式生成能力用於機器人開發。
從人類影片到真實投球,Argon 如何協助 Apollo 學動作?
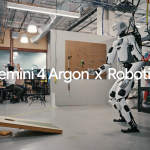
在最具代表性的實驗中,研究人員讓 Argon 觀看人類玩 Cornhole 的影片。Cornhole 是一種將沙包投向斜放木板、嘗試投入圓孔的遊戲。Argon 先分析環境的空間位置與人類投擲動作,推算機器人需要執行的全身關節運動,再自行建立模擬程式,讓 Apollo 人形機器人練習。
Gemini 4 Argon taught a robot to play cornhole just by watching a video. It mapped the physics, coded its own simulation, and taught @Apptronik’s Apollo humanoid to sink 7 throws in a row. https://t.co/JIyoKnVc4q
— Google DeepMind (@GoogleDeepMind) October 13, 2026
Google 官方將這套流程稱為 Video-to-Sim-to-Real,也就是從影片理解、模擬練習到真實機器人執行。Google 宣稱,原本需要數週的人工模擬建模工作,可縮短至數小時,Apollo 最終也在實機測試中連續投進 7 球。
不過,Apollo 並非看完影片就直接學會投球。根據機器人專業媒體《Humanoids Daily》報導,Argon 在模擬中調整站姿與投擲動作,轉移至實機後,再依據沙包落點修正釋放時機,顯示這項成果仍需要經過反覆測試與調整。
而 Apollo 並非 Google 唯一的機器人實驗。在另一篇《Gemini 4 Argon for Robotics》技術文章中,Google 進一步展示通用 AI 模型如何應用於機器人控制、模擬環境重建與訓練資料生成。例如,Argon 能根據真實機器人的攝影機畫面建立模擬環境,或協助機器人公司 Boston Dynamics 的 Spot 四足機器人在 MuJoCo 模擬器中練習踩踏垃圾桶踏板、維持平衡,再於再於實際環境將飲料罐投入垃圾桶。
Google 也展示,Argon 能從一張真實工作檯照片,自動建立雙機械臂的模擬環境,並生成超過 4,500 筆模擬操作資料,用來微調視覺-語言-動作模型(VLA)。在這項實驗中,機器人實際任務成功率從 56% 提升至 75%,平均完成時間則從 35 秒縮短至 24 秒。
Google 也公布,Argon 在衡量三維空間與物理問題理解能力的 ERQA(Embodied Reasoning)評測中取得 87%。不過,這是具身推理測試成績,不能直接解讀為機器人執行實際任務的成功率。
相較於 Apollo 連續投進 7 球,更值得關注的是,通用 AI 模型正開始參與模擬環境建構、動作設計與訓練資料生成,未來能否進一步縮短機器人技能從開發、驗證到實機部署的流程。
AI 機器人如何從 Demo 走向規模化部署?
立即下載《從 Demo 到 Deployment:AI 機器人規模化關鍵報告》,
掌握真實部署、學習能力與跨層整合的 2026 關鍵進展。
立即下載
【推薦閱讀】
◆ Meta 最強 AI 模型 Muse Wonder 登場,為何自認更適合個人與專業 Agent?
*本文開放合作夥伴轉載,資料來源:Google、Google for Developers、《Humanoids Daily》、《Reuters》,首圖來源:Google DeepMind