
撰稿:廖紹伶
企業開始讓 AI Agent 不只回答問題,還能規劃任務、存取資料、呼叫工具,甚至直接執行動作後,AI 治理也變得更複雜,而到了「Edge AI Agent」,問題又多了一層。資料與部分運算留在企業內部或終端裝置,乍看之下似乎更安全,但當 Agent 同時取得端點上的資料與執行能力,即使與中央系統失去連線,也可能繼續動作。換句話說,「資料不上雲」不代表企業就比較容易掌控 Agent。
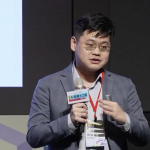
「Edge AI 的 Agent 相對會比較安全嗎?」KPMG 安侯企管數位創新服務副總經理張智淵在《科技報橘》主辦的 AI 智慧大工廠論壇中,就從這個問題切入。本集《全新一週》帶回這場演講內容精華,從 Edge AI Agent 與 Centralized AI Agent 的差異談起,再進一步拆解企業該在哪些環節建立控管,以及地端執行可能帶來哪些容易忽略的治理盲點。
Edge AI Agent 特別在哪?部分推理與執行能力來到端點
張智淵將 AI Agent 大致區分為 Centralized AI Agent 與 Edge AI Agent。前者的模型與 Agent 執行環境主要位於雲端,使用者透過網路下達任務,再取得回傳結果;Edge AI Agent 則會將部分甚至全部推理與行動能力放到終端裝置。
這個差異的重點不只在資料放哪裡。當 Agent 的執行能力也來到端點,它可能直接存取當地檔案、資料與系統,甚至在裝置上採取動作。企業因此要處理的,不只是模型輸出正不正確,而是 Agent 在端點上擁有哪些權限、可以做哪些事,以及發生異常時能不能及時停下來。
要管 AI Agent,得先把整個工作流程拆開來看
張智淵引用 KPMG 架構,將 Agent 工作流程拆成幾個階段:從使用者指令與資料輸入,到模型推理與任務規劃、記憶與資料取用、工具呼叫與行動執行,最後才是結果輸出。
不同階段需要注意的面向也不同。輸入端涉及 IAM(身分與存取管理)與資料保護,推理階段要管理模型,資料取用牽涉存取範圍,當 Agent 開始呼叫工具、執行動作,又需要限制它可以做什麼;監控日誌與人機協作則要貫穿整個流程。
張智淵形容,管理 Agent 有點像管理員工。企業不只要確認「它是誰」,還要規定它可以進哪些門、看哪些資料、使用哪些工具,以及哪些動作不能做。
斷網不代表動作停止,還可能讓企業暫時「看不到」
Edge AI Agent 最反直覺的治理盲點之一,就出現在斷網之後。張智淵舉例,如果 Agent 已經部署在裝置上,即使設備與中央系統失去連線,只要端點仍保有資料與執行權限,它就可能繼續動作。短短 10 分鐘內,Agent 仍可能刪除地端資料、覆寫檔案或執行其他操作;但中央系統此時反而無法即時掌握它做了什麼。
因此,張智淵認為 Edge AI Agent 除了一般 Agent 的治理措施外,還需要額外限制地端存取範圍與可執行動作、強化端點資料防護,並保留地端行為日誌。若裝置長時間無法回傳紀錄,也要考慮進一步限制,甚至終止部分功能。
不只管「能不能做」,還要避免資訊跟著任務流出去
另一個容易忽略的問題,出現在不同任務之間。張智淵舉例,同一個 Agent 可能先協助撰擬機密合約,接著又上網搜尋資料或訂機票。如果不同任務沿用相同上下文,前一項工作的敏感資訊,就可能跟著後續操作一起流出去。
因此,企業除了限制 Agent 可以做哪些事,也要管理不同 Session 之間的資訊隔離,避免只應存在於特定任務中的資料,被帶進另一個使用情境。
不同情境承受的風險不同,Agent 也不能一體適用
張智淵提醒,企業不能只從技術能力判斷 Agent 該怎麼管,還要回到實際使用情境。用來查詢公開資訊,和用來處理機密合約、操作企業系統,一旦出錯,企業能承受的後果顯然不同。真正要先確認的是:這個 Agent 被放在哪個環節,以及風險發生時,造成的衝擊是否在可承受範圍內。
這也關係到企業究竟要開放多少自主權。依照張智淵引用的 KPMG 框架,Agent 可以從 L0 的建議產出、L1 的受監督執行,進一步走到 L2 的邊界內自主、L3 的跨系統自主。自主程度越高,身分權限、工具限制、人機卡點、稽核與驗證也要跟著加強。
歡迎大家訂閱「科技報橘」YouTube 頻道,一起用《全新一週》節目,來迎接全新的一週!
*首圖來源:《TechOrange》