
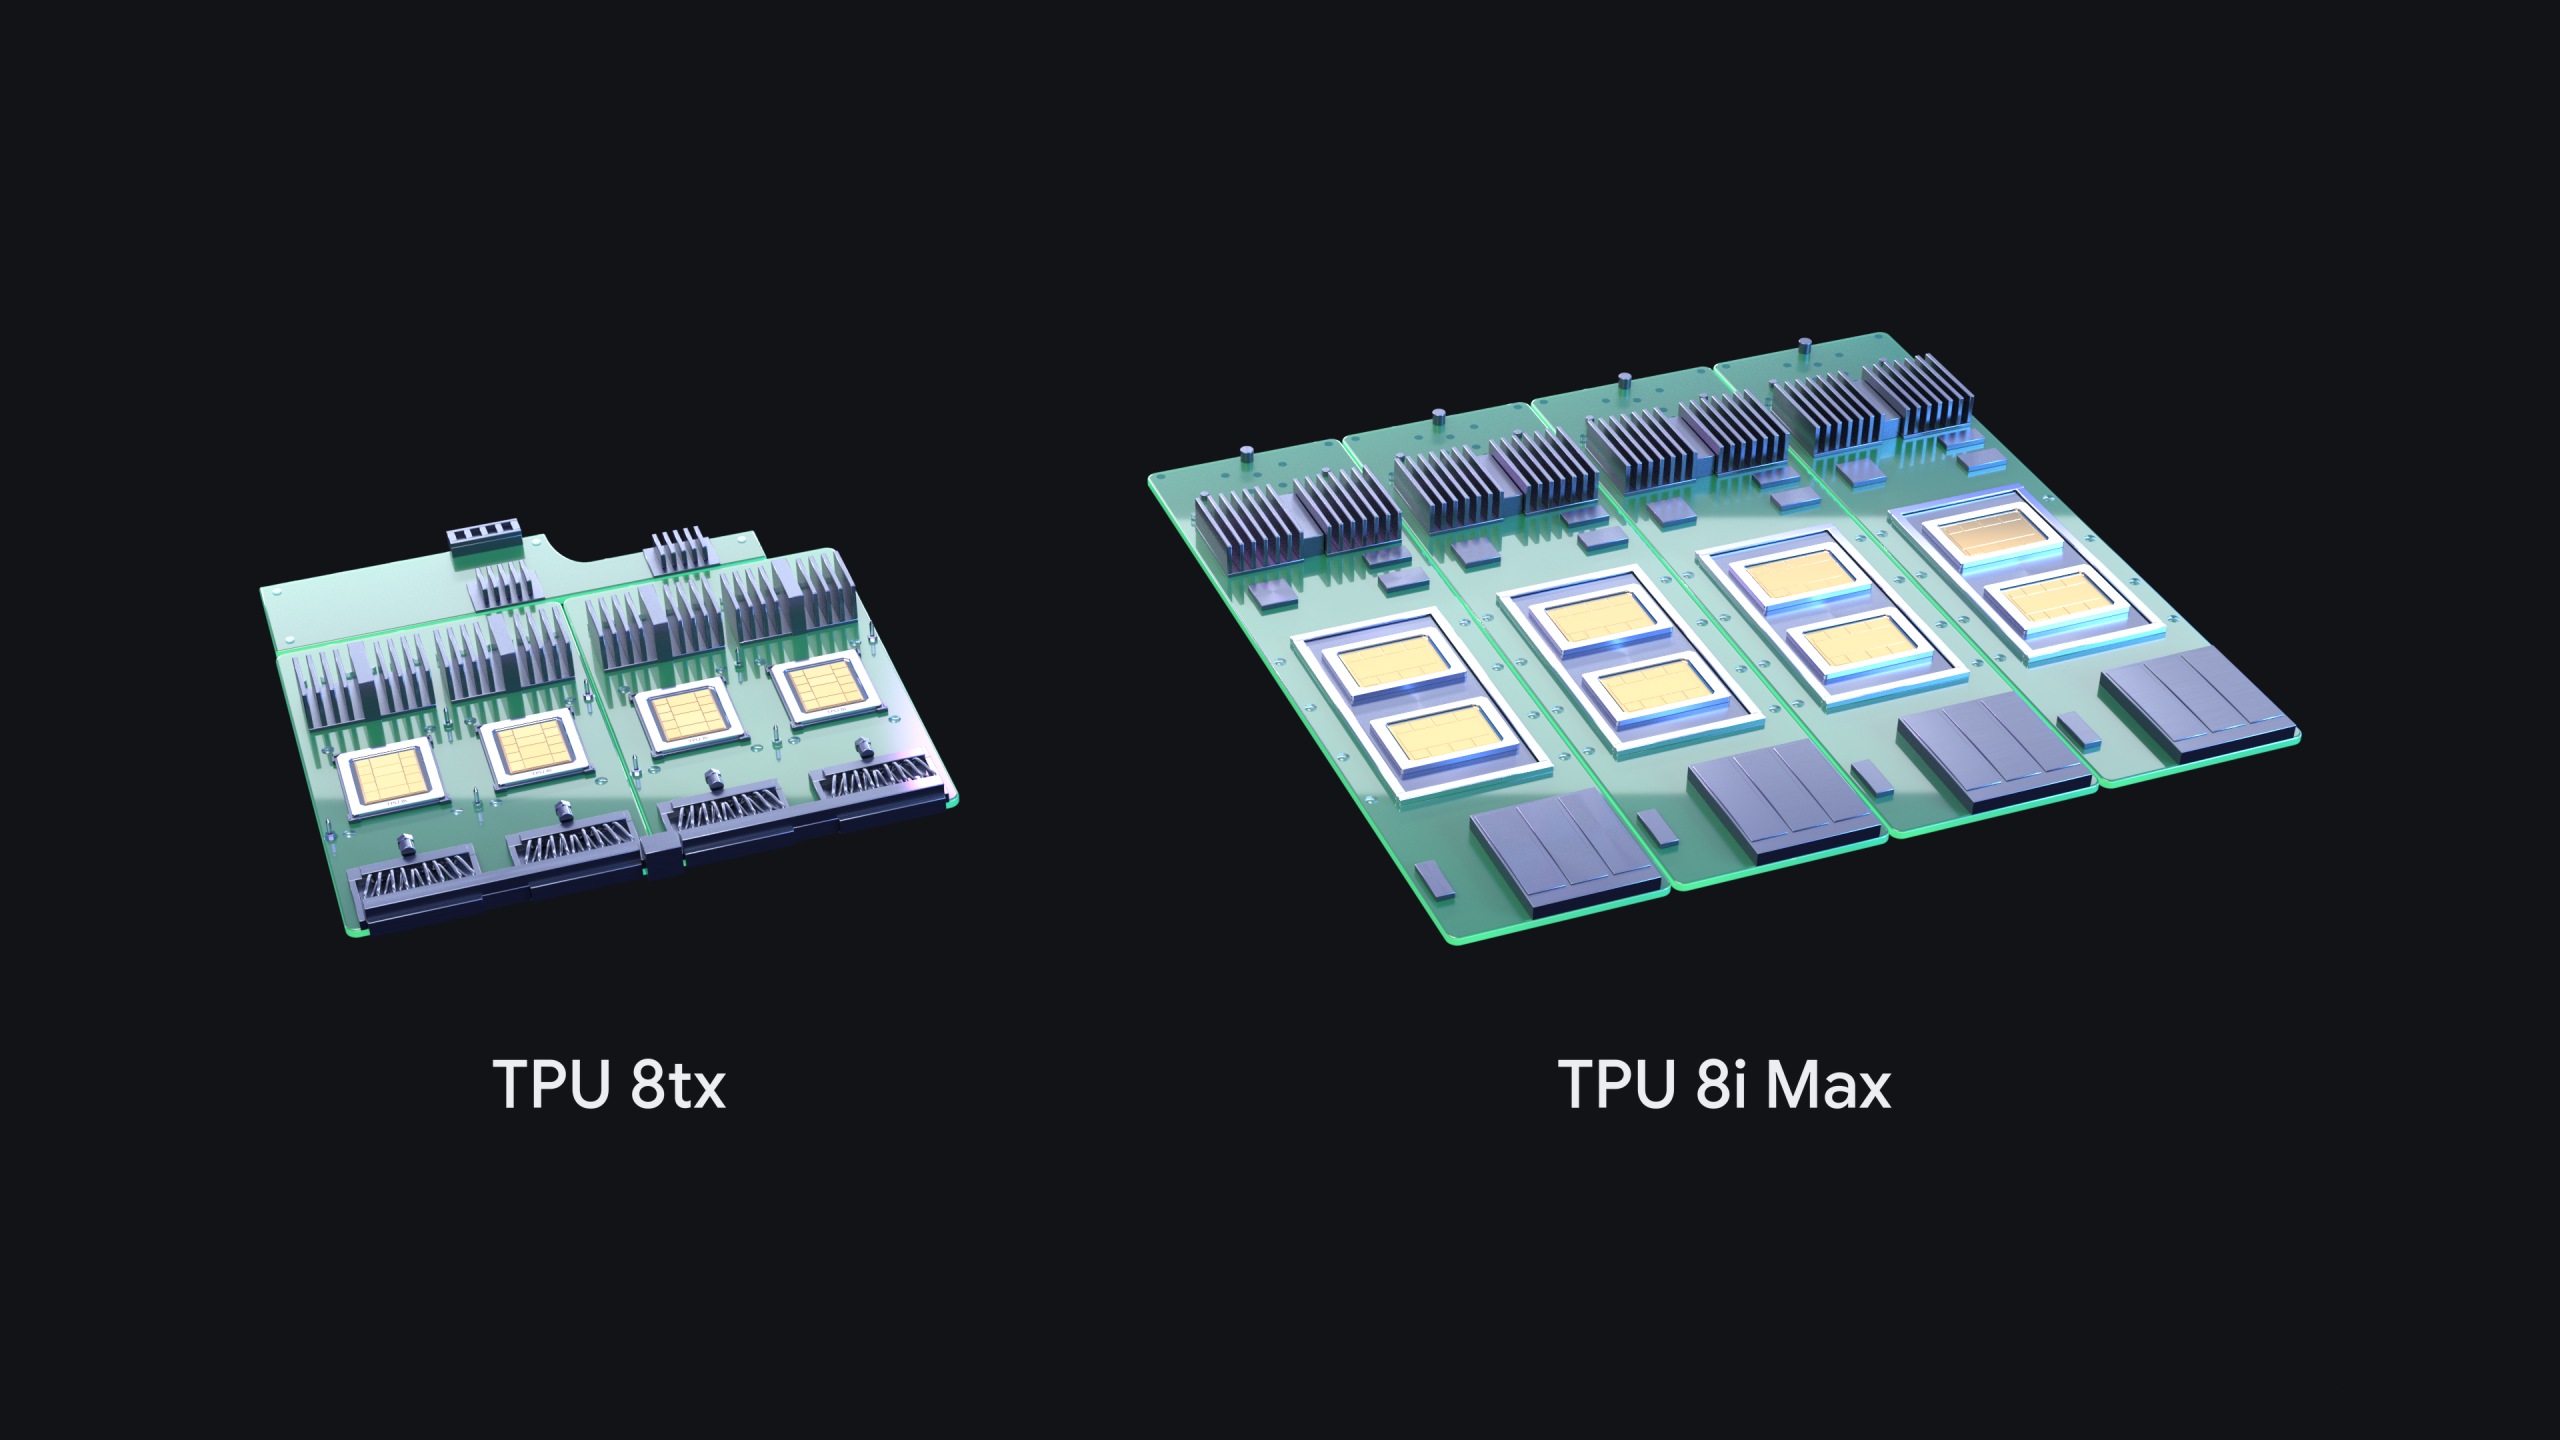
Google 正在加快自研 AI 晶片系統的更新腳步,繼今年 4 月推出第八代 TPU 8t、8i 後,Google 再發表 TPU 8tx、8i Max,首度在一年內推出四款 TPU 系統,分別鎖定模型訓練、低延遲推論、機密運算與超長上下文處理,也進一步擴大與 NVIDIA 在 AI 運算市場的競爭。
為什麼 Google 加快產品更新速度?Google Cloud AI 與運算基礎架構副總裁暨總經理 Mark Lohmeyer 在發布前媒體記者會指出,Google 過去約每兩年推出一款 TPU 系統,後來逐漸加快至每年一款、兩款,如今一年推出四款。背後的重要變化,是 AI Agent 正讓企業運算需求更加多元,也推動 AI 硬體朝不同工作負載專門化發展。
AI Agent 帶來三大轉變,運算需求不再只有一種
AI 從聊天問答走向自主執行任務的 AI Agent,正在改變底層運算需求。Lohmeyer 在記者會指出,Google 觀察到三大轉變。
一是運算需求從「人類規模」(human scale)走向「代理規模」(agent scale),單一使用者的請求可能觸發數十、數百甚至數千次操作;二是 AI 從讀取、整理資訊,進一步轉向實際操作企業系統,帶來新的資料安全與法遵要求;三是從簡單問答轉向複雜的多步驟任務,需要長時間處理大量文件、程式碼等上下文,對記憶體及資料傳輸能力提出更高要求。
Lohmeyer 表示,Google 已觀察到企業對機密運算、記憶體容量等方面的新需求,因此選擇針對不同工作負載設計專用系統,而非假設單一配置就能滿足所有需求。
TPU 8tx 強化機密運算,8i Max 突破記憶體瓶頸
根據 Google 官方公告,今年 4 月推出的 TPU 8t 主要針對大型模型訓練,TPU 8i 則著重低延遲推論。此次新增的兩款系統,進一步回應企業導入 AI Agent 時的資料安全與記憶體需求。
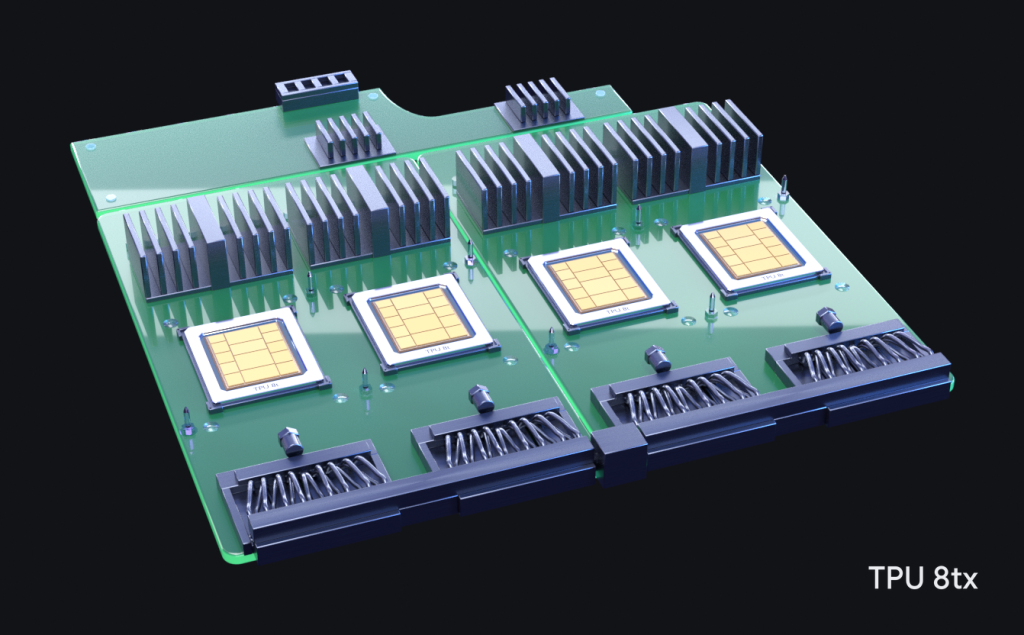
TPU 8tx 的特色,是將機密運算與低延遲推論整合至同一套系統。一般資料在儲存及傳輸時可以加密,但進行運算時通常需要解密,因而產生資料暴露風險。TPU 8tx 透過硬體層級的加密與隔離機制,讓敏感資料及模型權重在處理過程中也受到保護。
Lohmeyer 在記者會補充,保護範圍涵蓋提示詞、企業資料及專屬模型,甚至能降低基礎設施操作人員接觸機密資訊的風險。效能方面,Google 宣稱 TPU 8tx 相較 TPU 8t,推論延遲最多可降低一半。此外,企業也能在同一系統上進行模型微調、蒸餾與強化學習,減少敏感資料在不同運算叢集間移動的需求,適合金融、政府等重視資料安全的應用場景。
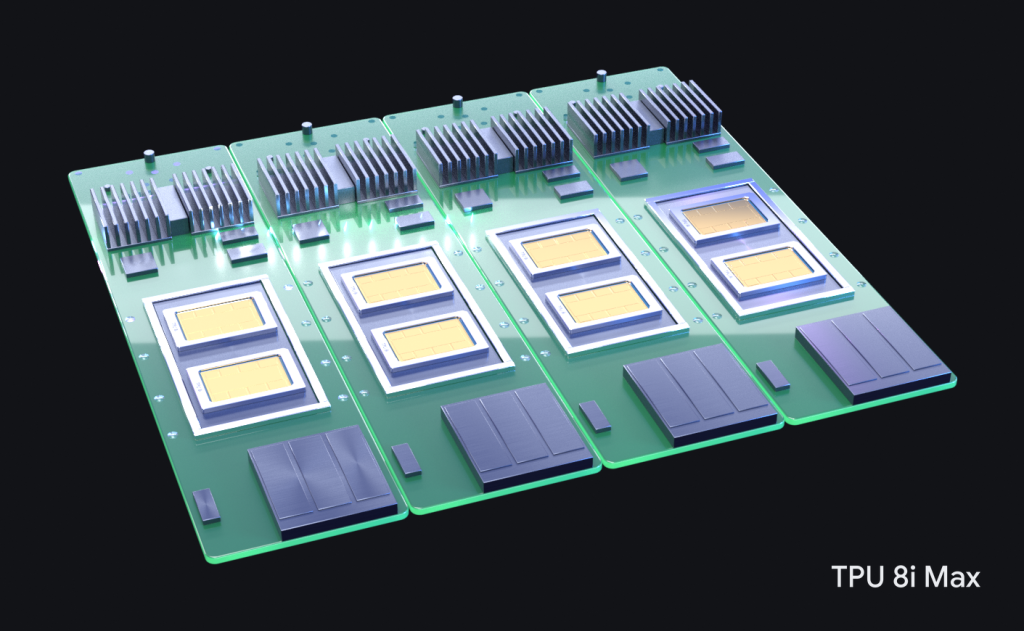
另一款 TPU 8i Max 則著重突破大型 AI Agent 工作負載的記憶體瓶頸。它提供 384GB 高頻寬記憶體(HBM),容量較 TPU 8i 增加約 33%;HBM 頻寬翻倍至每秒 17.2TB,晶片上的 SRAM 也翻倍至 768MB,運算能力同步提高一倍。
這項設計有助於多個 AI Agent 同時處理大型程式碼庫、長時間影片等龐大上下文。Lohmeyer 以高速公路比喻,這就像增加車道,不一定讓每輛車跑得更快,而是讓更多車輛能同時通行。Google 也表示,新系統能提高單一機櫃的運算密度,讓資料中心在相同空間部署更多運算資源。
不必重新設計晶片,Google 如何數個月內推出新系統?
值得注意的是,Google 這次發表的兩款 TPU 系統,並沒有重新設計底層晶片,而是沿用今年 4 月推出的 TPU 8t、8i,透過調整封裝、網路拓撲與安全機制,打造出不同用途的運算系統。
以 TPU 8tx 為例,它採用與 TPU 8t 相同的晶片,但將原本應用於 TPU 8i 的 Boardfly 低延遲網路架構整合進來,縮短晶片之間的通訊路徑;同時搭配 AMD 支援機密運算的 x86 CPU,加入硬體層級的加密與隔離機制。如此一來,Google 不必重新開發晶片,就能讓原本以訓練為主要用途的 TPU 8t,延伸出兼顧機密運算與低延遲推論的新系統。
TPU 8i Max 則採取另一種做法,將兩顆既有 TPU 8i 晶片整合至單一封裝,並調整系統配置,讓運算能力及記憶體頻寬翻倍,以支援大型上下文與更多平行執行的 AI Agent 工作負載。
Google 在官方技術說明中指出,重新設計晶片涉及數十億個電晶體的配置,以及複雜且漫長的製造流程,往往需要數年。相較之下,若將晶片視為可重複使用的基礎模組,工程團隊就能針對新需求,重新組合封裝、記憶體、網路及安全防護機制,在數個月內推出專用運算系統。
除了模組化設計,Google 也能從自家 AI 模型及服務取得需求回饋。Lohmeyer 在媒體問答中表示,Google 透過 DeepMind,以及搜尋、Gmail、YouTube 等內部應用,能較早觀察到新的運算需求,再將這些經驗反映至系統設計。他認為,硬體基礎設施與軟體系統,正越來越朝特定工作負載及應用情境進行專門化。
Google 擴大 TPU 生態系,與 NVIDIA 競爭不只靠硬體
除了加快硬體更新,Google 也試圖降低企業採用 TPU 的門檻。Google 今年 10 月開源 TorchTPU,讓習慣使用 PyTorch 的開發者,能以較少程式碼修改,在 TPU 上執行既有模型,並支援 vLLM、SGLang 等推論工具。
TPU 的商業布局也持續擴張。Lohmeyer 在記者會提到,Google 已有超過 100 家具實質使用規模的 TPU 客戶,包括 Anthropic、Apple、Citadel 等企業。Google 10 月也宣布與 Oracle 合作,預計自 2027 年起在 Oracle Cloud Infrastructure 提供 TPU,擴大自研晶片的使用管道。
不過,Google 並未因此放棄 NVIDIA GPU。Lohmeyer 說明,Google Cloud 同時提供 TPU 與 NVIDIA GPU,企業可以透過 Google Kubernetes Engine(GKE),依工作負載及資源狀況選擇運算平台。
從加快 TPU 系統更新,到降低開發門檻、擴大雲端通路,Google 正試圖讓 TPU 成為更多企業可選擇的 AI 運算基礎設施。隨著 AI Agent 對效能、安全及記憶體提出不同要求,AI 晶片競爭也逐漸從單純比較算力,延伸至整體系統設計與軟體生態系。
【推薦閱讀】
◆ Google 看 AI 硬體下一步:運算便宜、搬資料昂貴,專用化還會加深
*首圖來源:Google Cloud