
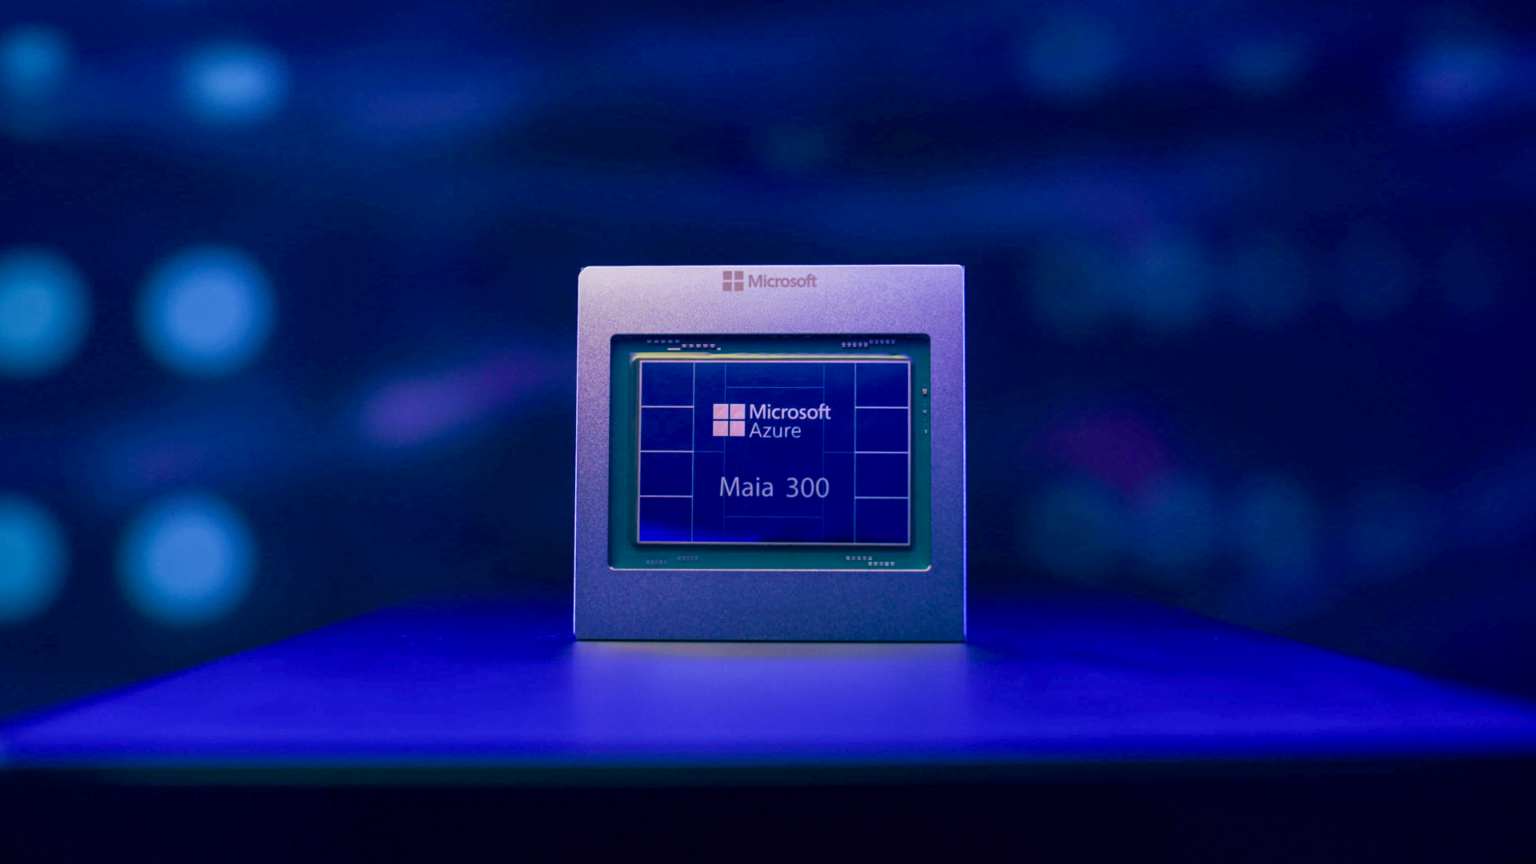
微軟正準備讓自研 AI 晶片承擔更大規模的運算任務。其發表第三代 AI 晶片 Maia 300,宣布自 2027 年起將 Maia 系統擴展至數 GW(百萬瓩)規模,成為旗下產品與服務的主要 AI 推理平台。《Reuters》報導,潛在部署數量可能超過 100 萬顆。
當 AI 推理走向如此龐大的部署規模,如何讓新增算力真正轉化為服務能力?根據微軟官方公告,Maia 300 的機櫃級 token 吞吐量最高達前代 Maia 200 的 7 倍,每瓦效能提升超過 2.5 倍。這些數字背後不只是單顆晶片變快,而是涉及記憶體、網路、電力與散熱的整體設計。
單顆晶片更快還不夠,Maia 300 如何讓整個機櫃效率提升?
大型 AI 推理系統的效能,並不只取決於晶片運算速度。隨著 AI 應用走向長上下文推理、多步驟 Agent 任務,模型需要處理更多上下文資料,並可能由多顆加速器共同執行。記憶體存取速度、資料搬移及晶片間通訊,都可能成為效能瓶頸。微軟在技術解析文章指出,Maia 300 的設計重點之一,就是減少資料搬移造成的運算與能源負擔。
首先,Maia 300 配備 8 組 HBM4 高頻寬記憶體,最高頻寬達每秒 18 TB,是前代的 2.5 倍。同時,微軟將晶片內部記憶體改為重視資料位置的 NUMA 架構,讓資料盡可能靠近使用它的運算單元,減少不必要的傳輸。此外,透過低精度資料格式,也能降低每次推理需要儲存與搬移的資料量。
但大型模型往往需要多顆晶片協作,單顆晶片的效率改善仍不足以解決所有問題。因此,Maia 300 每個機櫃整合 96 顆加速器,是前代的 2 倍。微軟也重新設計晶片互連網路,讓資料能在同一機櫃內,甚至跨機櫃直接傳輸,減少通訊環節造成的負擔。官方指出,最多可串連 12,288 顆加速器,形成共同運作的運算叢集。
這些技術共同支撐 Maia 300 機櫃級 token 吞吐量最高提升 7 倍的表現。不過,這是完整機櫃的比較,包含加速器數量增加,並不代表單顆晶片效能提高 7 倍。
數 GW 規模如何真正上工?電力與散熱也是關鍵
即使晶片與網路效率提升,要在資料中心部署大量加速器,仍面臨電力供應、散熱與機櫃空間的限制。根據微軟架構說明,Maia 300 每個機櫃整合 96 顆加速器,整體功率約 167 kW。如此高密度的配置,不只需要供電,也必須有效排除運算產生的熱量,才能持續運行。
為此,微軟採用混合式散熱設計,透過液冷帶走超過 80% 的機櫃熱負載,其餘元件則使用氣冷處理,讓系統能適應不同資料中心的冷卻條件。
另一項設計是將電力管理延伸到資料中心層級。微軟表示,Maia 300 可結合機櫃與資料中心的電力監測資訊,動態調整功率分配、AI 工作負載的位置及部署密度,提高有限電力資源的利用率。這也反映微軟衡量 AI 晶片效能的方式。根據官方公告,Maia 300 預期每 MW 電力可處理的 token 數,較領先 GPU 系統提高 40%。
這仍是微軟公布的預期效能,而非全面部署後的實測成果。但 Maia 300 揭示的方向是:當 AI 推理邁向百萬顆晶片規模,競爭不只在於單顆晶片能算多快,更在於記憶體、網路、電力與散熱能否共同配合,讓有限的資料中心資源承擔更多 AI 工作。
【推薦閱讀】
◆ ASML 下一代 Hyper NA 瞄準 5 奈米解析度,EUV 技術還有多少微縮空間?
*本文開放合作夥伴轉載,資料來源:《The Verge》、Microsoft 1、Microsoft 2、《Reuters》,首圖來源:Microsoft