
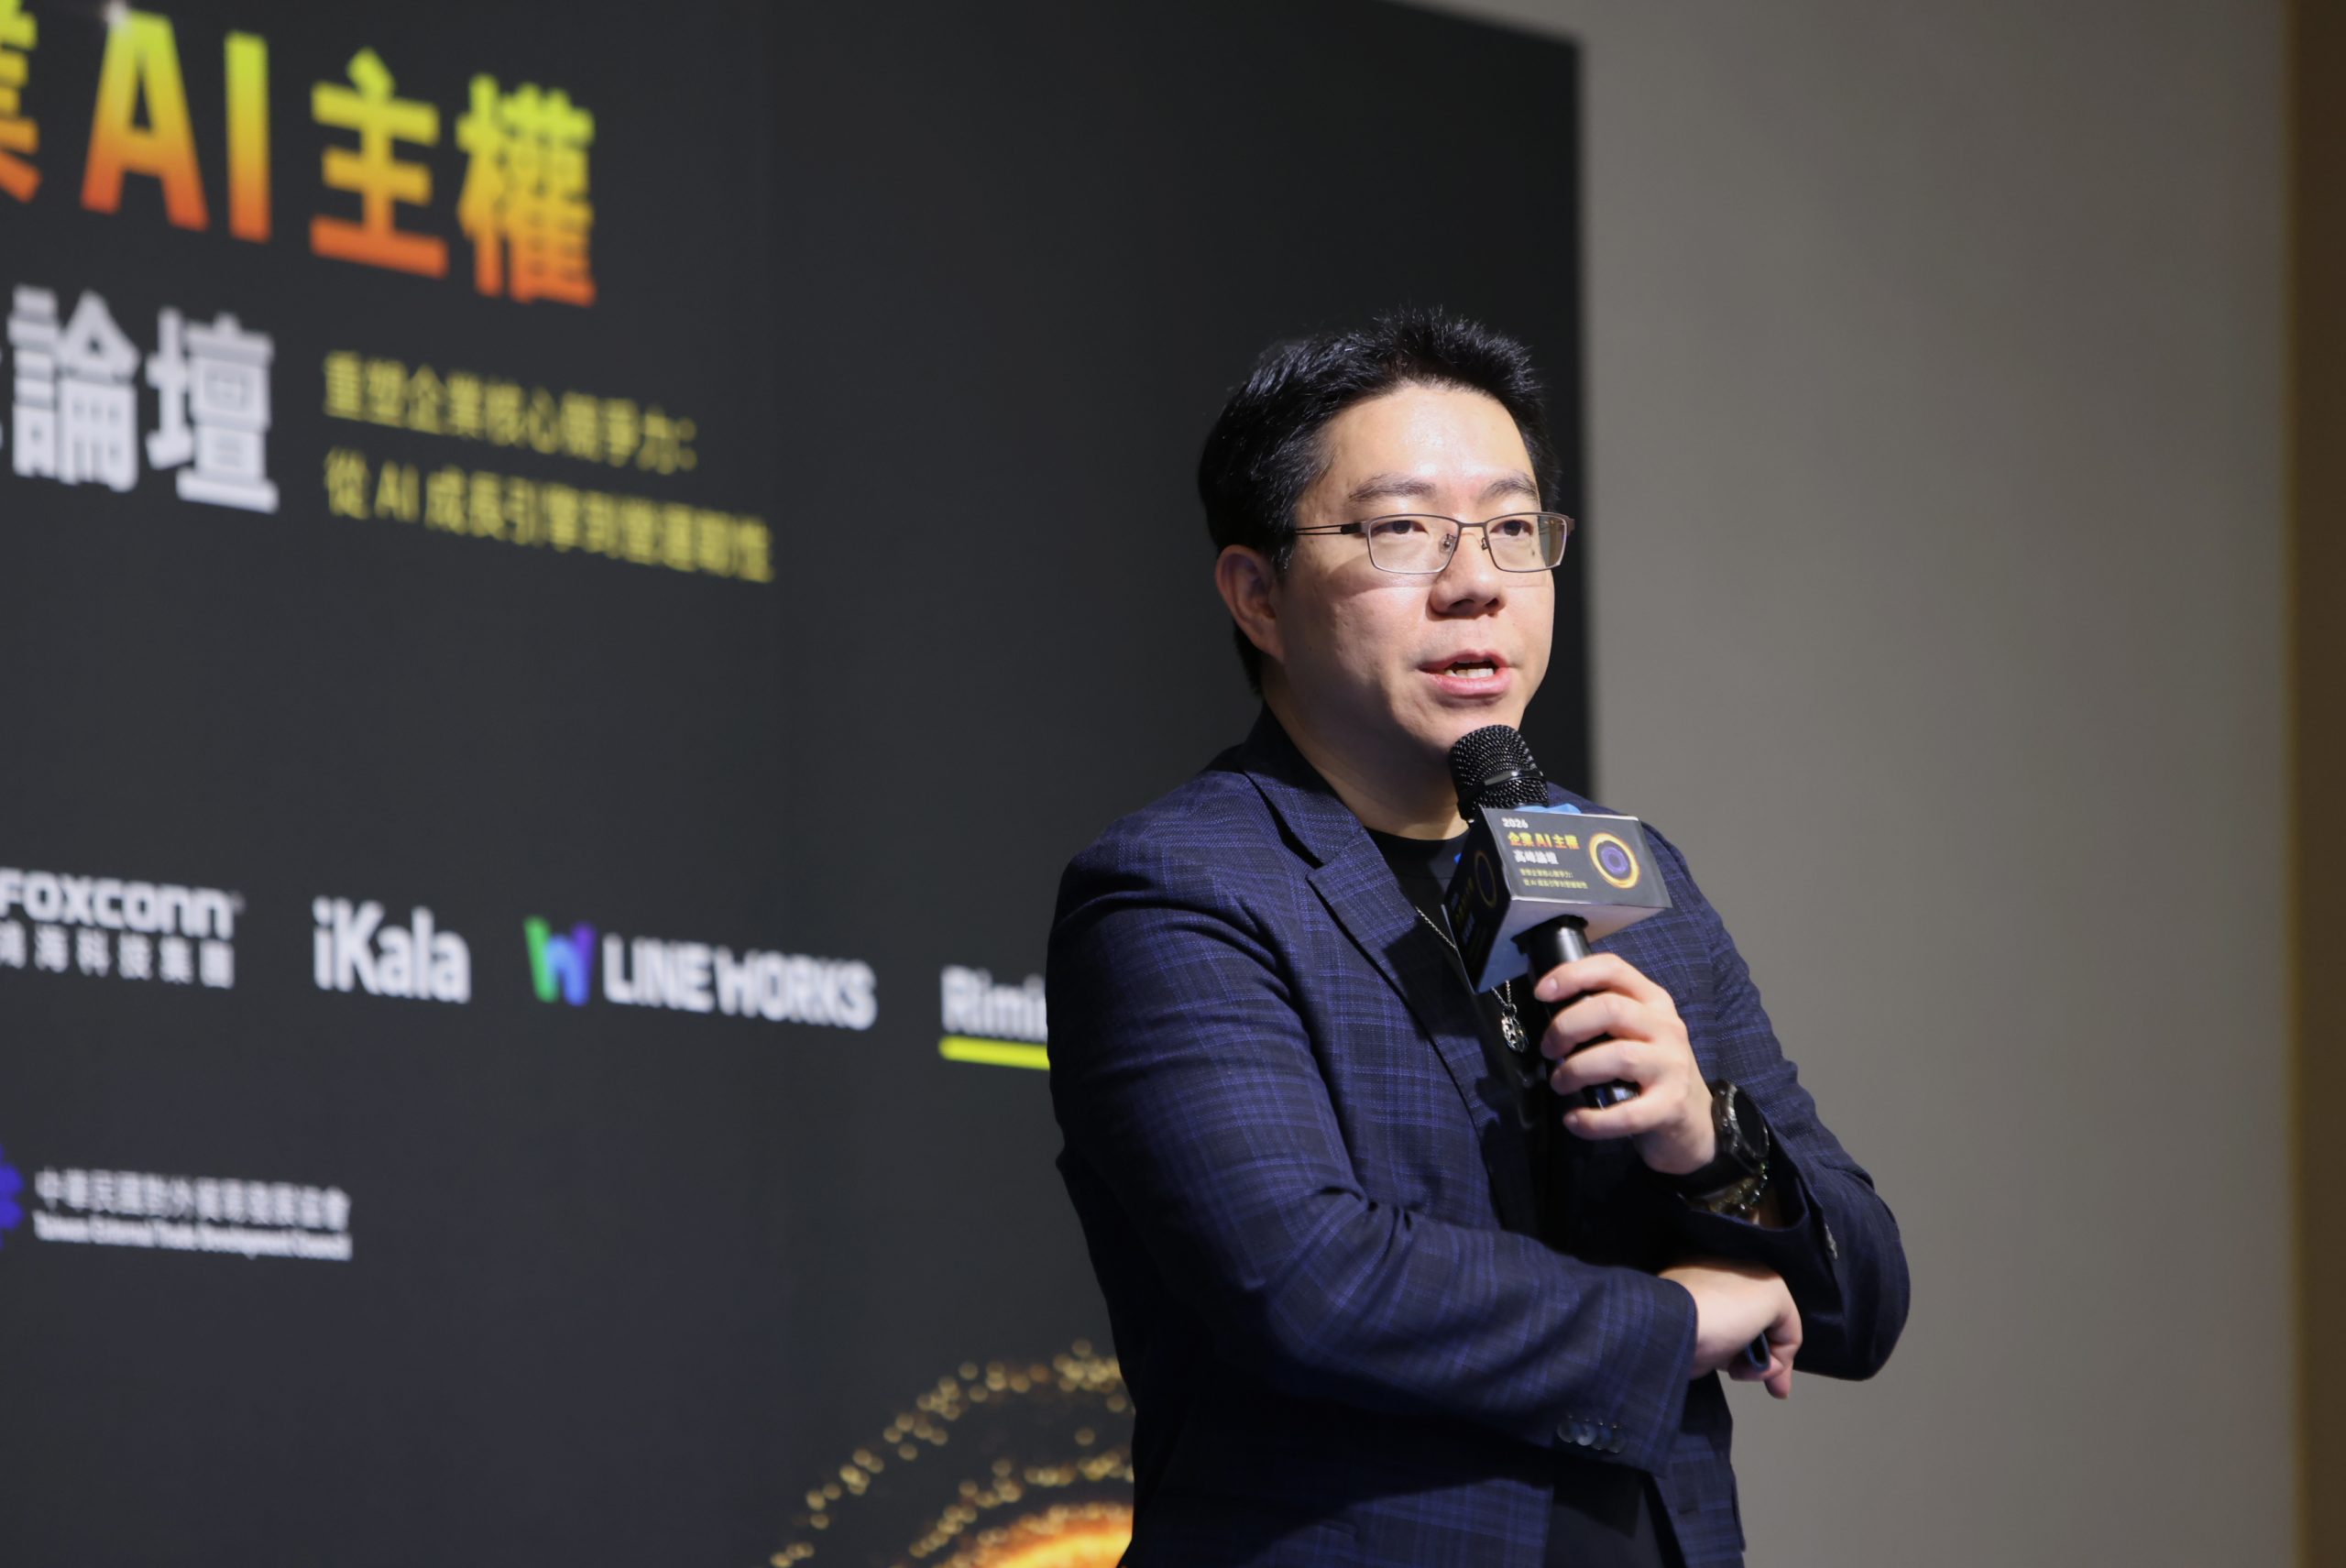
「用繁體中文請 AI 說出一種黃色、帶刺的熱帶水果叫什麼,它可能會回『菠蘿』,而不是『鳳梨』。」看似只是用詞習慣的差異,卻反映出 AI 在理解繁體中文與台灣在地語境時,仍有值得改善的空間。在科技報橘日前舉辦的「2026 企業 AI 主權高峰論壇」,iKala 共同創辦人暨集團董事長程世嘉引用美國團隊 2025 年發表的研究,研究人員以 110 個台灣與中國大陸用法不同的詞彙,測試 11 個主流 AI 模型。結果發現,以繁體中文提問時,每個模型平均有 37.5 題未能使用符合台灣習慣的詞彙回答;改用簡體中文提問後,平均僅有 4.4 題不符合中國大陸的用語習慣。當 AI 成為企業查資料、做判斷的入口,讓 AI 讀懂語言與市場、確保模型理解在地語境,也成為主權 AI 發展的重要課題。
程世嘉回顧文字與科技發展的歷程:電報時代每個漢字得先編成四碼數字才能傳出去,電腦時代使用倉頡輸入法,再到網路時代,光是讓機器學會替沒有空格的中文斷詞就是一門學問。過去,科技主要協助人們輸入、傳遞與搜尋文字;如今,AI 不僅能理解語言、生成內容,更逐漸參與資訊整理與決策輔助。當科技從處理文字走向理解語意,AI 能否準確掌握在地語言與文化脈絡,也變得更加重要。
全球主權 AI 背後的三大生存風險
根據 Google 公布的數據,其單月處理的 token,從 2024 年的 9.7 兆個、2025 年的 480 兆個,到今年 5 月已超過 3,200 兆個,程世嘉稱之為「智慧通膨」,當 AI 能力持續提升、使用門檻逐漸降低,智慧服務也開始像水電一樣,成為隨時可用的基礎設施。
隨著 AI 深入產業與社會運作,各國也加速布局主權 AI,希望掌握模型、資料與運算資源。輝達 2026 財年的主權 AI 營收突破 300 億美元,年增逾三倍,南韓辦主權 AI 國家隊選拔,Naver 今年 1 月因不符「從零訓練」的要求在首輪出局;瑞士去年發表的 Apertus,連權重與訓練資料都全面開源;冰島則由總統發起與 OpenAI 合作,找來 40 位志工教 GPT-4 正確的冰島語。
雖然各國在主權 AI 的路線不同,面對的卻是同樣三種風險:第一是「聽不懂」,以 Meta 的 Llama 2 為例,訓練資料約九成是英文,中文只占 0.13%;第二是「被定義」,過去通常都是用主流的方式衡量 AI 能力,但 AI 所回答的答案也是「被定義」出來的;第三是「被切斷」,AI 可能會面臨因出口管制而暫停模型無法使用。
回到台灣,行政院「AI 新十大建設」2027 年度預算案編列 406 億元,數位發展部的主權 AI 訓練語料庫截至 8 月底已累積約 22 億個 token。程世嘉形容:「算力像教室、語料像課本、模型像學生,但缺了考卷,就永遠不知道學生到底學會了沒有。」
因此,iKala 決定自己出這張考卷。2024 年 3 月,iKala 發表繁體中文評測基準 TMMLU+,從幾百份台灣公開考試整理出多道題目,範圍涵蓋台語、中醫臨床、稅務公文和論文,當時第一份成績單就點出落差,結果顯示台灣考生平均 68.2 分,當時最強的模型只有 62.1 分,GPT-4 則是 58.4 分,如今模型能力大幅進步, TMMLU+ 相關評測正確率已提升至 97% 以上。
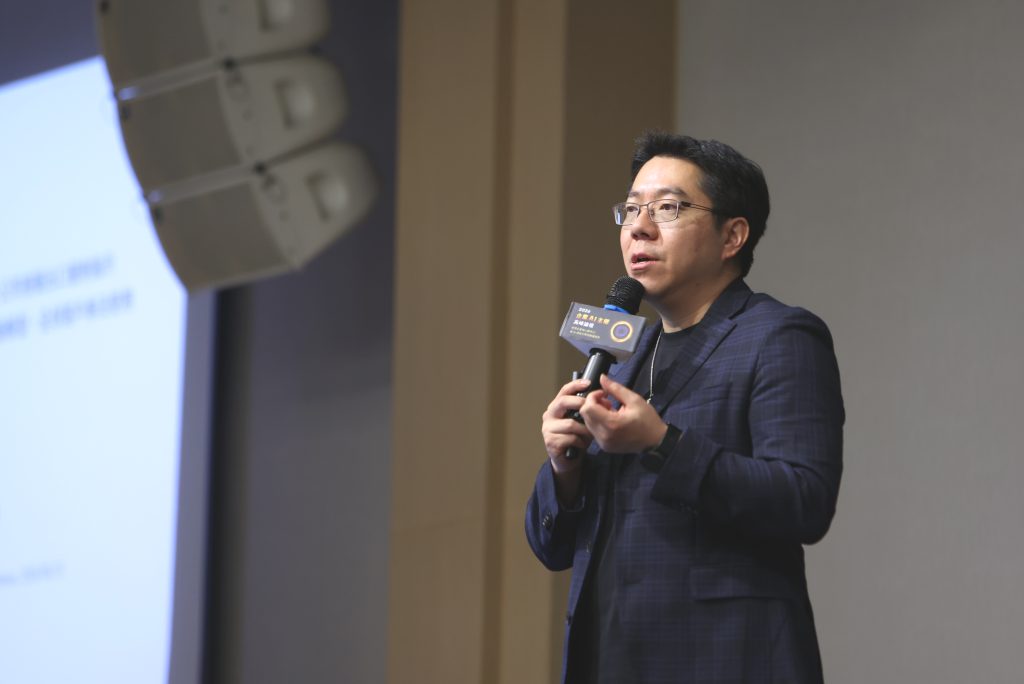
程世嘉表示,目前 Google、Meta、聯發科 MediaTek Research Breeze、鴻海 FoxBrain、國科會 TAIDE 都使用 TMMLU+ 作為評測基準,EleutherAI 的開源評測工具也把 TMMLU+ 內建成標準任務。
iKala 接下來會把 TMMLU+ 評測延伸到 AI Agent 與多模態領域,檢驗 AI 能不能在台灣的真實情境裡把事情做完,對企業而言,挑選 AI 的標準也將從「答得對不對」,轉向「事情做不做得成」。
「五十年後,AI 又會用什麼語言來回答?」程世嘉強調,保存數位文化資產是不可忽視的責任, 並在最後提出一個問題讓大家思考,五十年後,如果有人想知道 2026 年的台灣人怎麼說話、怎麼思考,他大概不會去翻書,而是選擇去問 AI,到那時 AI 又會用什麼語言回答?