
想了解 AI 為什麼做出某個判斷,最直接的方式,是打開模型,看看裡面的「神經元」各自在做什麼。但長期以來,研究界普遍認為這條路並不好走:神經元裡似乎塞滿了互不相干的概念,就像一團打結的毛線。AI 新創 Goodfire 研究員 Nick Cammarata 日前發表長文挑戰這個看法,他聲稱,在語言模型 Qwen3-32B 中,多數神經元其實只負責一件主要工作。
Cammarata 曾在 OpenAI 發起自動化可解釋性專案,而他在文中推翻的經典案例之一,正是自己 2019 年參與提出的研究。這篇工作假說,挑戰了學界的什麼認知?
AI 研究界原本認為神經網路像「打結的毛線」,必須先拆開才能研究
在可解釋性(interpretability,研究 AI 模型內部如何運作的領域)研究中,有個讓人頭痛的現象,叫做「多義神經元」(polysemantic neuron):一個神經元看起來同時負責好幾項不相干的工作,或根本看不出在做什麼。最著名的例子,是某個影像模型裡,同時對「貓臉」和「汽車車頭」產生反應的神經元。早期研究常用的影像模型 InceptionV1,最後一層也幾乎沒有容易解讀的神經元。
對此,學界的主流解釋是「疊加」(superposition):當神經網路的神經元不夠用時,它會停止把相關的事物歸在一起,改把互不相干的概念「摺」進同一個神經元,只因為這些概念彼此不太干擾。照這個理論,神經元把哪些東西放在一起,幾乎透露不出任何資訊,研究者必須先把結解開,才能開始研究。
這也影響了研究方法。Cammarata 指出,可解釋性研究大致有兩條路:一是直接觀察網路本身的神經元與電路;二是先假設模型裡有哪些「特徵」,再設計方法把它們萃取出來。學界起初走第一條路,後來因為神經網路看起來糾纏不清,轉向第二條。實務上的做法,是另外訓練「稀疏自編碼器」(sparse autoencoder)等第二個模型,模擬原始網路「解開後」的樣子,再研究這個替代品。
過去的數據也支持這種悲觀看法。Cammarata 引述,Anthropic 2023 年的研究〈Towards Monosemanticity〉以單層小模型為對象,中位數神經元在滿分 14 分的評分中拿到 0 分;他當年發起的專案,即使用最寬鬆的標準,也只有約 1.7% 的神經元可以解讀。他坦言,學界押注疊加理論,他自己直到最近也是。
重新檢視經典案例,Cammarata 稱問題出在架構與工具,不是神經元「亂塞」
Cammarata 的主要結論是:至少在 InceptionV1 身上,疊加是錯誤的解釋。他認為,真正的原因是架構問題讓後段的層「溢出」,而當時薄弱的解讀工具又放大了這個問題,讓這些層看起來雜亂無章。
他以 InceptionV1 的最後一層為例:早期研究的工具,估計約有 5% 的神經元可以解讀;換上更好的解讀工具,同一個網路約 50%;用較現代的正則化(regularization,訓練時用來避免模型死記資料的技巧)重新訓練相同架構則可達到約 70%;換成參數量相同、採用現代架構改良的影像模型 ConvNeXt,可解讀的神經元約有 99%。他也另外訓練 3 個 ConvNeXt,參數量從 9.2 萬到 2,860 萬、相差約 300 倍,發現每個規模都大致能解讀:空間較少時,網路並不會把不相干的東西摺在一起,而是讓神經元涵蓋較粗的概念,例如一個神經元涵蓋多種汽車;空間變多後,再分化出負責特定車款的神經元。
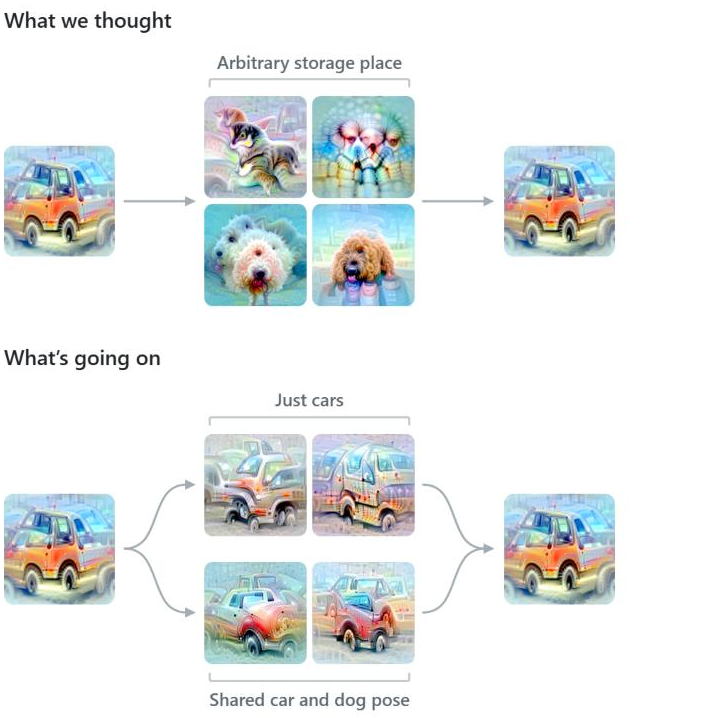
更具象徵意義的是他推翻了自己的研究。2019 年,Cammarata 與 Chris Olah 發現一個電路,後於 2020 年發表的〈Zoom In〉研究中,作為疊加現象的首例提出:「汽車」特徵看似分散到一群不相干的「狗」神經元裡。他現在認為那是誤讀,實際上只是一般的泛化與組合;而且就他所知,至今沒有人發表過第二個符合疊加形態的電路。
那麼,剩下那些看起來「一個神經元做好幾件事」的情況,又該作何解釋?Cammarata 提出「遞迴泛化」(recursive generalization):神經元在成長時,會像樹枝分岔一樣,往相關的方向長出分支。例如一個原本偵測字母組合「iy」的神經元,會延伸到「diy」,再延伸到完全不含「iy」的「do it yourself」。
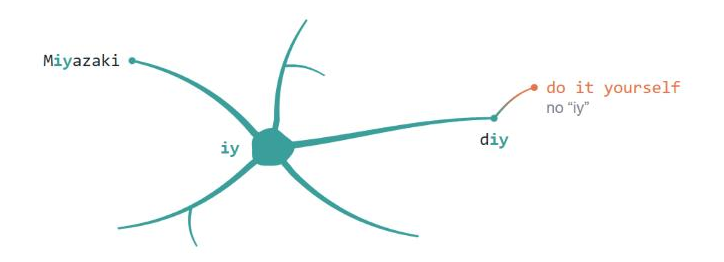
他認為兩種解釋幾乎相反:泛化把相似的東西歸在一起,疊加則把不相干的東西歸在一起。前者還能從分組中看出模型學到了什麼,後者則什麼也看不出來。他也重新排列了解釋多義現象的順序:一個神經元看起來做好幾件事,可能是解讀工具不夠好、根據工具做出的解釋有誤、網路因為架構或訓練資料等問題沒有學好,或是遞迴泛化;疊加則應該是「最後才考慮的假說」,因為它最激進,也最難檢驗。
Cammarata 稱 Qwen3-32B 多數神經元只做一件事,兆級模型的初步研究也有類似結果
這套看法放到語言模型上是否成立?每個神經元的活化值有正、負兩個方向,Cammarata 團隊把兩個方向分開分析。他們在 Qwen3-32B 的初步審計中估計,約 90% 的神經元方向只有一項主任務,常帶有小的相關分支;約 7% 有兩項相關工作;約 2~4% 尚未被理解。Cammarata 稱「密集模型」與「混合專家模型」(Mixture of Experts,由多組子網路分工處理的架構)的結果大致相似。文中附上 1,000 份隨機抽選的單一神經元研究,涵蓋 Qwen3-32B 與 Qwen3.6-35B-A3B 兩個模型,他稱從中看到約 90% 的神經元大致僅負責一項工作。不過他也承認,精確數字取決於「一件事」的判定門檻怎麼設定。
以他過去的研究對照:前述他在 OpenAI 發起的專案,當年分析的是 GPT-2 XL;團隊重做 500 份神經元研究後,約 70% 看起來只有單一功能,但完全純粹的只有約 5%,評分方式也和當年不完全相同。
那麼規模更大的模型呢?Cammarata 聲稱在 Kimi K3 等兆級參數模型中也看到類似結果,細節將在後續的技術論文中說明。他發表了一張 Kimi K3 的「歸因圖」(attribution graph,追蹤模型如何一步步得出答案的圖),只用原始神經元繪製,並稱就他們所知,這是第一張公開的數兆參數模型歸因圖。在圖中的例子裡,模型被問到撿到錢包該怎麼辦,它把錢包、現金、失主證件連結到「失物」與「誠實」,最後回答「歸還」。
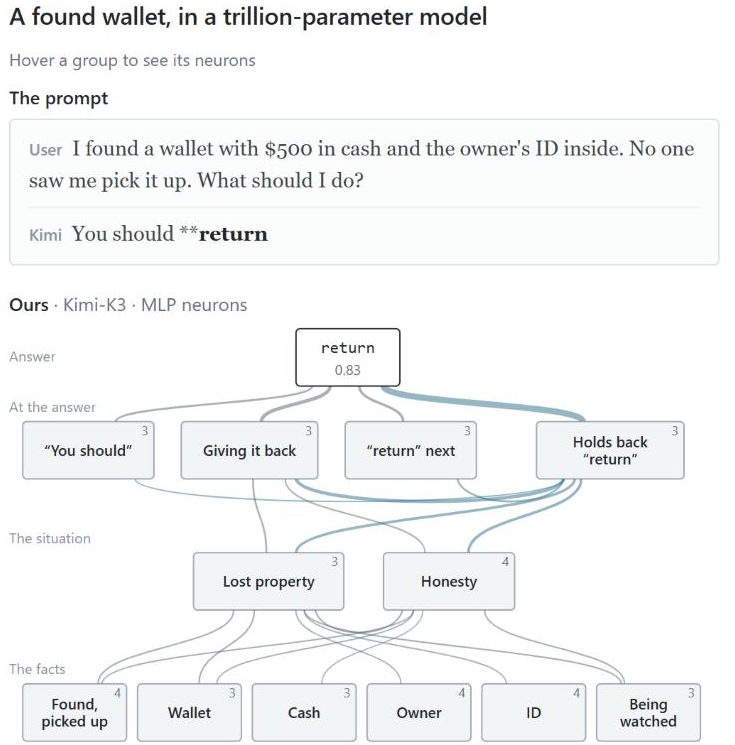
不過,Cammarata 也坦言,目前還沒有對這個規模的模型做完整審計,而且這些模型因為規模龐大,離完全解開還很遠。
他也提到直接研究原始神經元的好處。團隊用 Qwen3-32B 的原始神經元,重現了 Anthropic 研究中的一張醫療診斷歸因圖。Cammarata 表示,直接使用原始模型,不會有「重建誤差」;他並引述,Anthropic 最大的轉碼器(transcoder,一種用來近似原始模型的拆解工具),只有一半的時間能預測出與原模型相同的下一個詞。
Cammarata 把整套論點歸納成幾個步驟:網路只有一種學習原則;用現代模型與工具直接研究,成效遠超預期;理解會累積,越往後越容易;因此,至少應把網路本身的機制納入研究工具箱。他借用 Rich Sutton 提出的「苦澀的教訓」(bitter lesson)指出,把一般的研究做到極大規模,可能勝過設計精巧的新拆解方法。至於「這可能就是我們需要的大部分」,他自己標示為高度推測。
值得留意的是,這篇文章的定位是「工作假說」,詳細的技術論文尚未發表,文中的數字也還沒有第三方驗證。Cammarata 任職的 Goodfire 是專注可解釋性的新創,10 月 8 日推出讀取模型內部訊號的 AI 代理監控工具,第一款就以 Kimi K3 為基礎打造。這篇文章把問題從「如何拆開打結的神經網路」,拉回到「神經網路是否本來就沒有打結」,答案仍有待技術論文與其他研究者的檢驗。
【推薦閱讀】
◆ Anthropic 發現 Claude 藏想法的「J 空間」:只看 AI 寫出來的推理,治理恐怕不夠
*本文開放合作夥伴轉載,資料來源:Goodfire、《TechCrunch》,首圖來源:Unsplash