
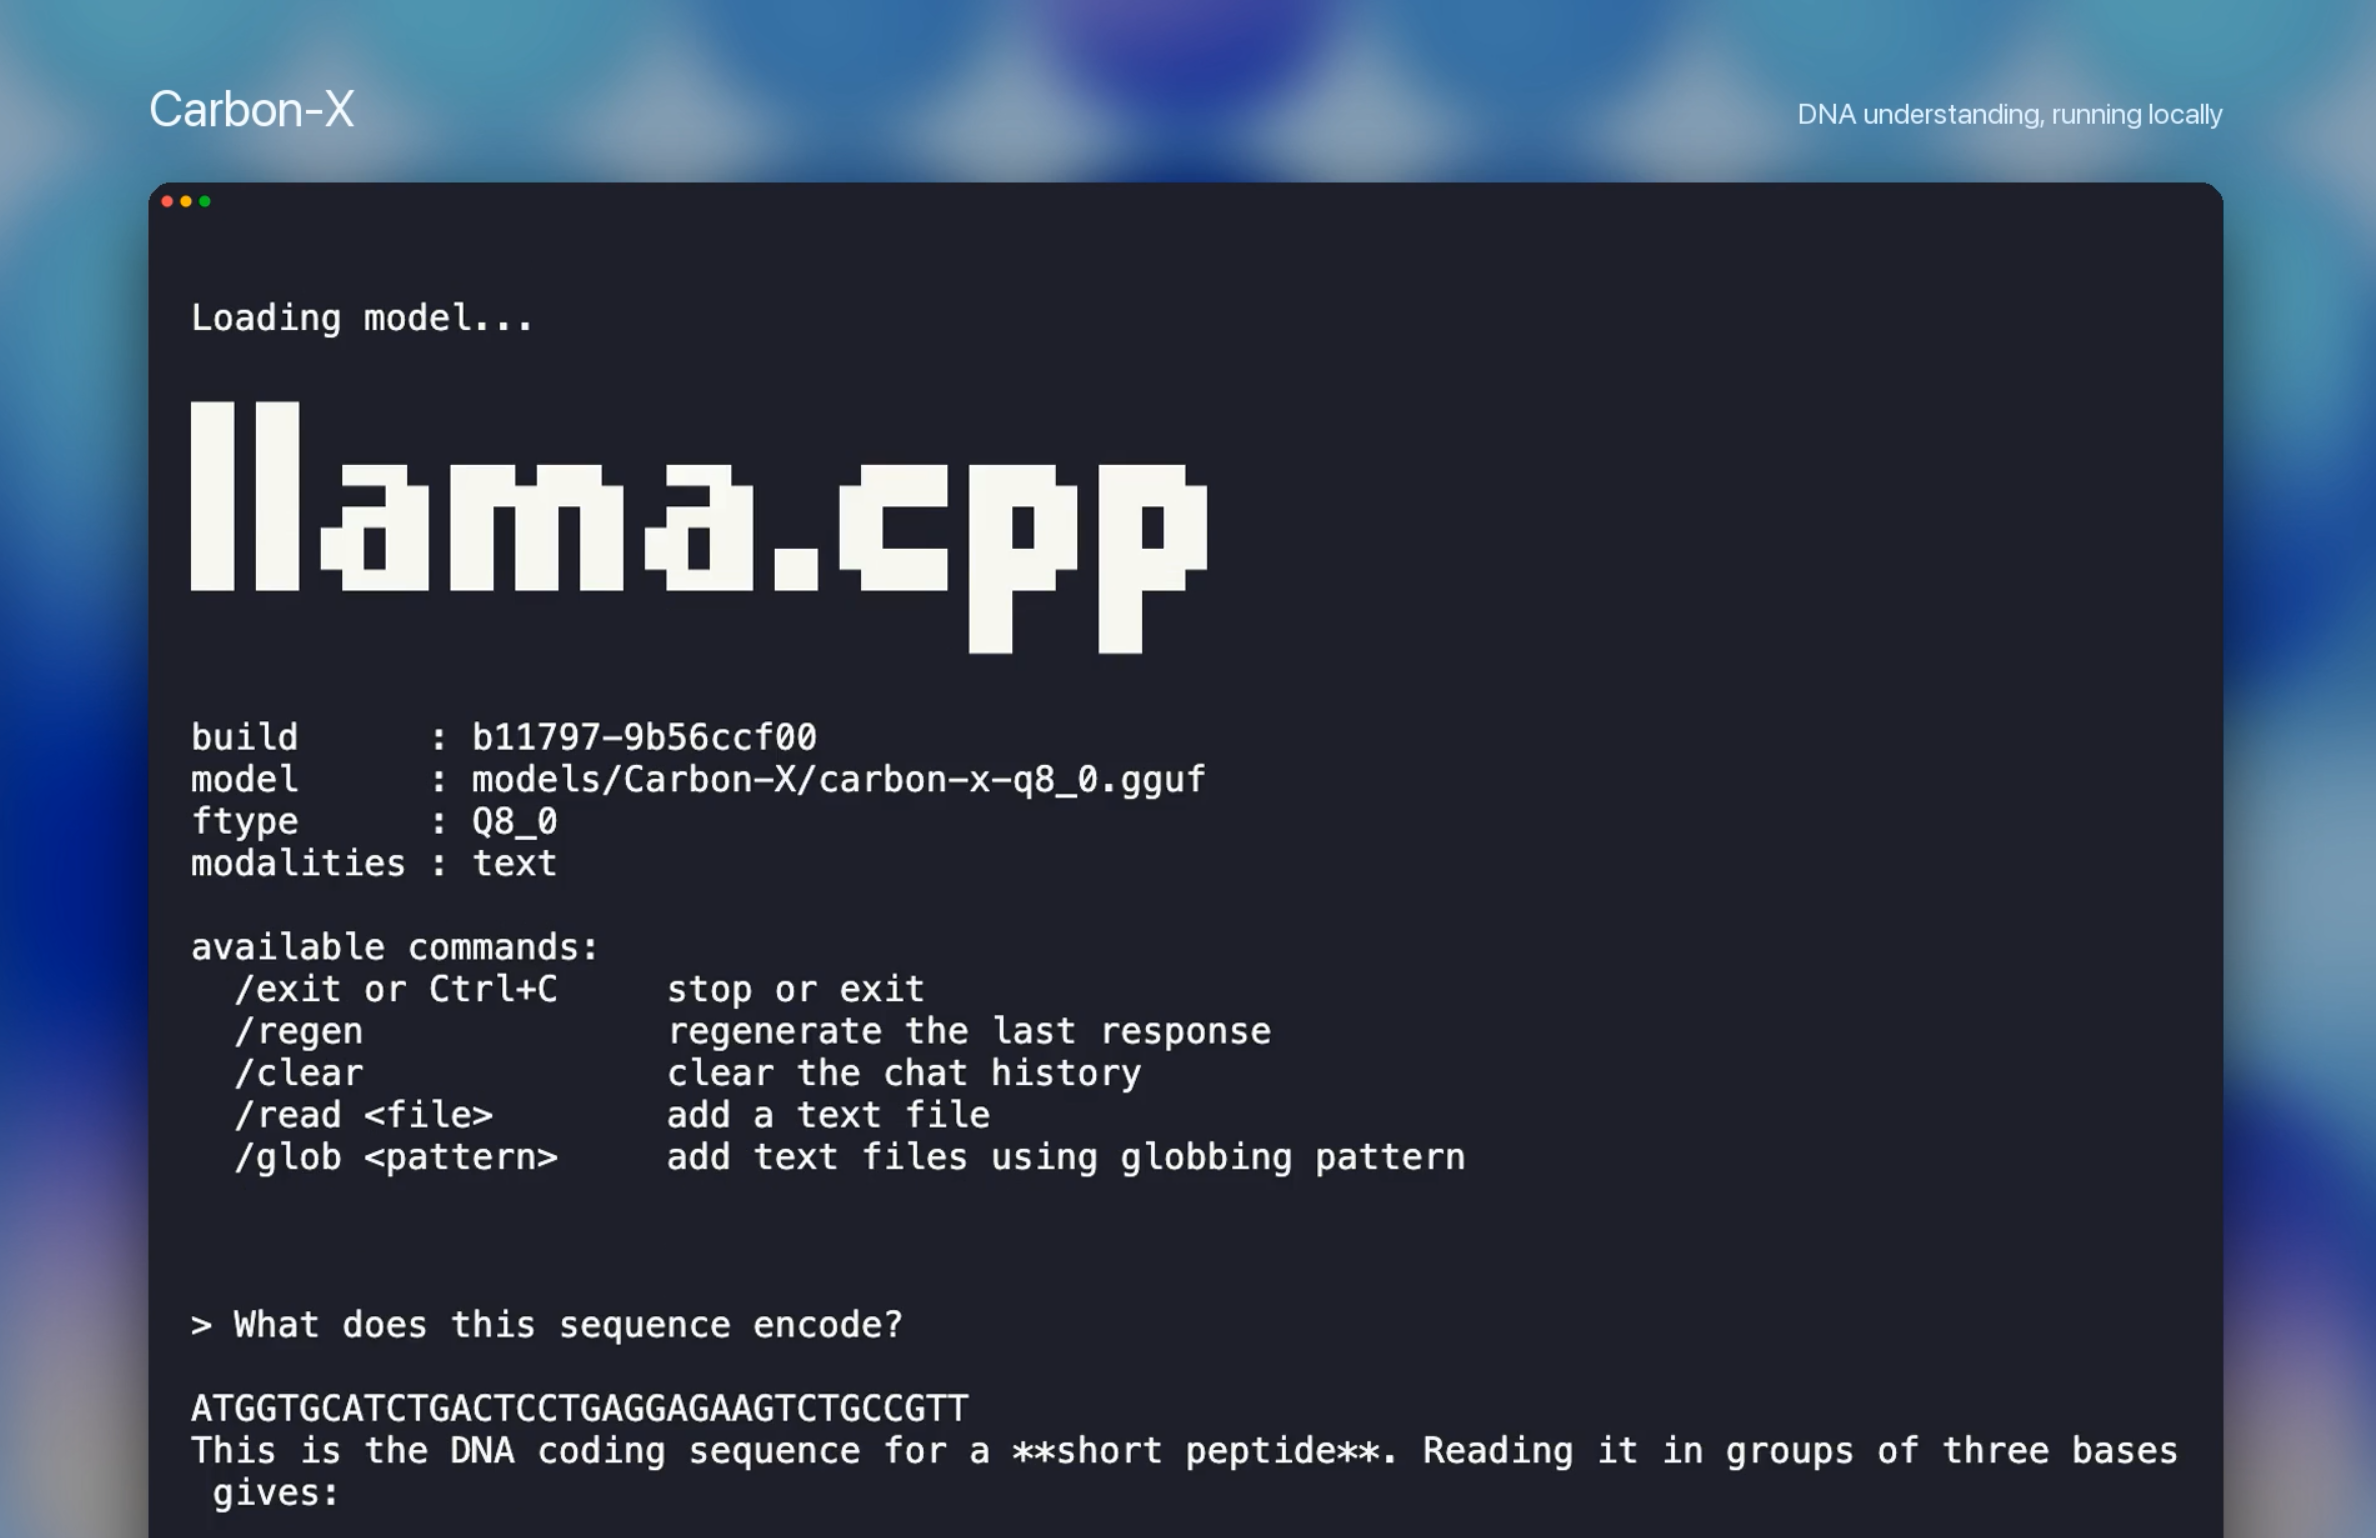
AI 模型分享與開發平台 Hugging Face 近日推出開源 AI 模型 Carbon-X,讓研究人員能貼上 DNA 序列,以自然語言提出問題,並取得模型的解讀、預測或說明。Hugging Face 資深研究科學家 Lewis Tunstall 接受《Business Insider》採訪時表示,Carbon-X 是「首創」的模型,結合 DNA 分析與自然語言,讓研究人員基本上可以「與 DNA 對話」。
Carbon-X 由 Hugging Face、中國中關村學院(Zhongguancun Academy),以及義大利 Telethon 遺傳與醫學研究所(Telethon Institute of Genetics and Medicine)與那不勒斯費德里科二世大學(University of Naples Federico II)的研究團隊共同開發。模型擁有 148 億個參數,以阿里巴巴的 Qwen3-14B 為基礎,再以 DNA 序列與自然語言進行訓練,訓練資料涵蓋人類、其他哺乳類、植物與真菌等物種的 DNA 序列。NVIDIA 已於 9 月同意以近 130 億美元收購 Hugging Face。
將 DNA 分析轉化為自然語言對話,基準測試平均得分 66.7%
DNA 以 A、C、G、T 四種鹼基儲存遺傳資訊。Carbon-X 的特色是將 DNA 序列與自然語言整合在同一個模型中,DNA 與文字共用同一組 token 序列,沒有獨立的 DNA 編碼器。根據官方模型文件,Carbon-X 採用混合式分詞器(tokenizer),文字沿用原本的詞彙表,DNA 則以每 6 個鹼基為一組進行編碼;模型先以 3,020 億個 token 的 DNA、生物學文獻、英文文本與指令資料進行中期訓練,再經過監督式微調與強化學習。
使用者可以將 DNA 序列與問題放在同一則訊息中,由模型判斷突變屬於良性或致病性、辨識調控基因活性的區域、依物種類群分類序列、預測序列接下來的鹼基,並說明推理過程。Tunstall 舉例,研究人員可以提供一段 DNA 序列,詢問某個突變是否會提高罹病風險,模型便會給出預測與解釋。
《CNET》指出,Carbon-X 並不是實驗室儀器,無法實際為 DNA 定序,而是讀取文字檔中的 DNA 序列等資料,再回答使用者的提問。Tunstall 表示:「Carbon-X 特別擅長協助研究人員研究基因變異,例如預測 DNA 序列的某項改變是否可能有害。」
在效能方面,Hugging Face 以五項基準測試評估 Carbon-X,涵蓋基因變異效應預測、DNA 序列理解及下一個鹼基預測等任務,Carbon-X 平均得分為 66.7%。根據 Hugging Face 的測試結果,這比作為基礎的 Qwen3-14B 高出 27 個百分點,並領先其評估的其他開放模型,與 OpenAI 的 GPT-6.1 Sol 的 67.5% 相近,但每道題目的推理成本約只有後者的 1,800 分之一。其中,Carbon-X 在蛋白質編碼區域的變異效應預測,以及下一個鹼基預測兩項測試中,表現優於所有受測模型;但在插入、刪除等非單核苷酸變異的測試中,Carbon-X 的 85.1% 則落後 GPT-6.1 Sol、Anthropic 的 Opus 5.5 與 Google 的 Gemini 4 Argon。
官方文件並估算,若要分析公開基因變異資料庫 ClinVar 中約 240 萬筆意義未明的基因變異(variants of uncertain significance),使用 Carbon-X 的成本約為 300 美元,受測的前沿模型則需要 3.2 萬美元至 400 萬美元。
開源、可本機部署,避免研究人員依賴大型 AI 實驗室
Carbon-X 採用 Apache 2.0 開源授權,研究人員可以透過開源工具 Transformers 載入模型,或使用推理框架 vLLM 部署推理服務。官方文件指出,BF16 精度的模型權重可在單張 80GB 記憶體的 GPU 上執行,研究人員可以將敏感或尚未發表的序列保留在自家的運算環境中,不必與外部 AI 公司分享病患資料。Tunstall 表示:「研究人員需要能夠研究、調整,並在自己的硬體上處理敏感或未發表序列的模型。」
不過,官方文件同時提醒,基因資料高度敏感,若透過推理 API、第三方推理服務或線上展示等不同方式使用模型,輸入與輸出的資料可能由不同業者以不同方式處理,使用者應先了解並同意資料的處理方式。
Tunstall 表示,Hugging Face 開發 Carbon-X 的部分動機,是避免生物研究人員過度依賴大型 AI 實驗室。他以數學領域為例指出:「如果你真的想推進數學的前沿,你很可能必須待在 OpenAI 或 Anthropic 這類 AI 實驗室,因為他們擁有最好的數學模型。」他認為,其他科學領域也可能出現類似情況。他補充:「我們希望為開放研究社群提供工具,讓他們不必完全依賴某個外部的單一供應商。」
此外,Carbon-X 還能整合至 AI 代理的工作流程。通用型 AI 助理在遇到與 DNA 相關的問題時,可以呼叫 Carbon-X 進行分析。Tunstall 表示,Carbon-X 能讓其他 AI 模型在需要擷取資訊時,取得一位 DNA 專家的協助。
Carbon-X 尚未經臨床驗證,長期目標是實現個人化醫療
Hugging Face 坦言 Carbon-X 仍有多項限制。官方文件指出,Carbon-X 只是連結 DNA 與語言研究的起點,尚未經過臨床驗證,不應用於醫療決策。模型可能數錯鹼基、混淆座標或做出錯誤的編輯,在長序列中定位精確位置時尤其明顯;若提示中缺乏足夠資訊,模型可能捏造序列的身分或功能。此外,Carbon-X 在不同任務上的表現並不平均,剪接位點與組蛋白標記相關問題的得分分別只有 29.8% 與 34.6%;被要求產出較長的 DNA 序列時,品質會下降。
Tunstall 表示,為了避免模型遭到濫用,Carbon-X 的訓練資料刻意排除了病毒。他也提到,通用型聊天機器人有時會將研究人員正當的生物學問題,誤認為試圖「設計生物武器」而拒絕回答。
Tunstall 認為,雖然 Carbon-X 主要會由研究人員使用,但它代表朝向 AI 協助提供更個人化醫療的一小步。他說:「我認為終極目標,大致上是個人化醫療的概念,讓我們每個人都能拿著自己的病歷、自己的基因組,最終找到、甚至可能設計出屬於自己的治療方式。」
Tunstall 表示:「我們認為研究人員也需要開放的替代方案,讓他們能獨立檢驗模型的能力、限制與風險。透過公開釋出 Carbon-X 及其訓練方法,我們讓更廣泛的科學社群能測試它在哪些地方有效、找出它在哪些地方失敗,並協助改進它。」
【推薦閱讀】
◆ 從聯發科到 Hugging Face,NVIDIA 為何接連往 AI 生態不同環節出手?
*本文開放合作夥伴轉載,資料來源:《CNET》、《Business Insider》、Hugging Face,圖片來源:Hugging Face。