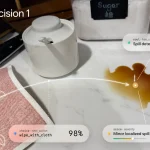

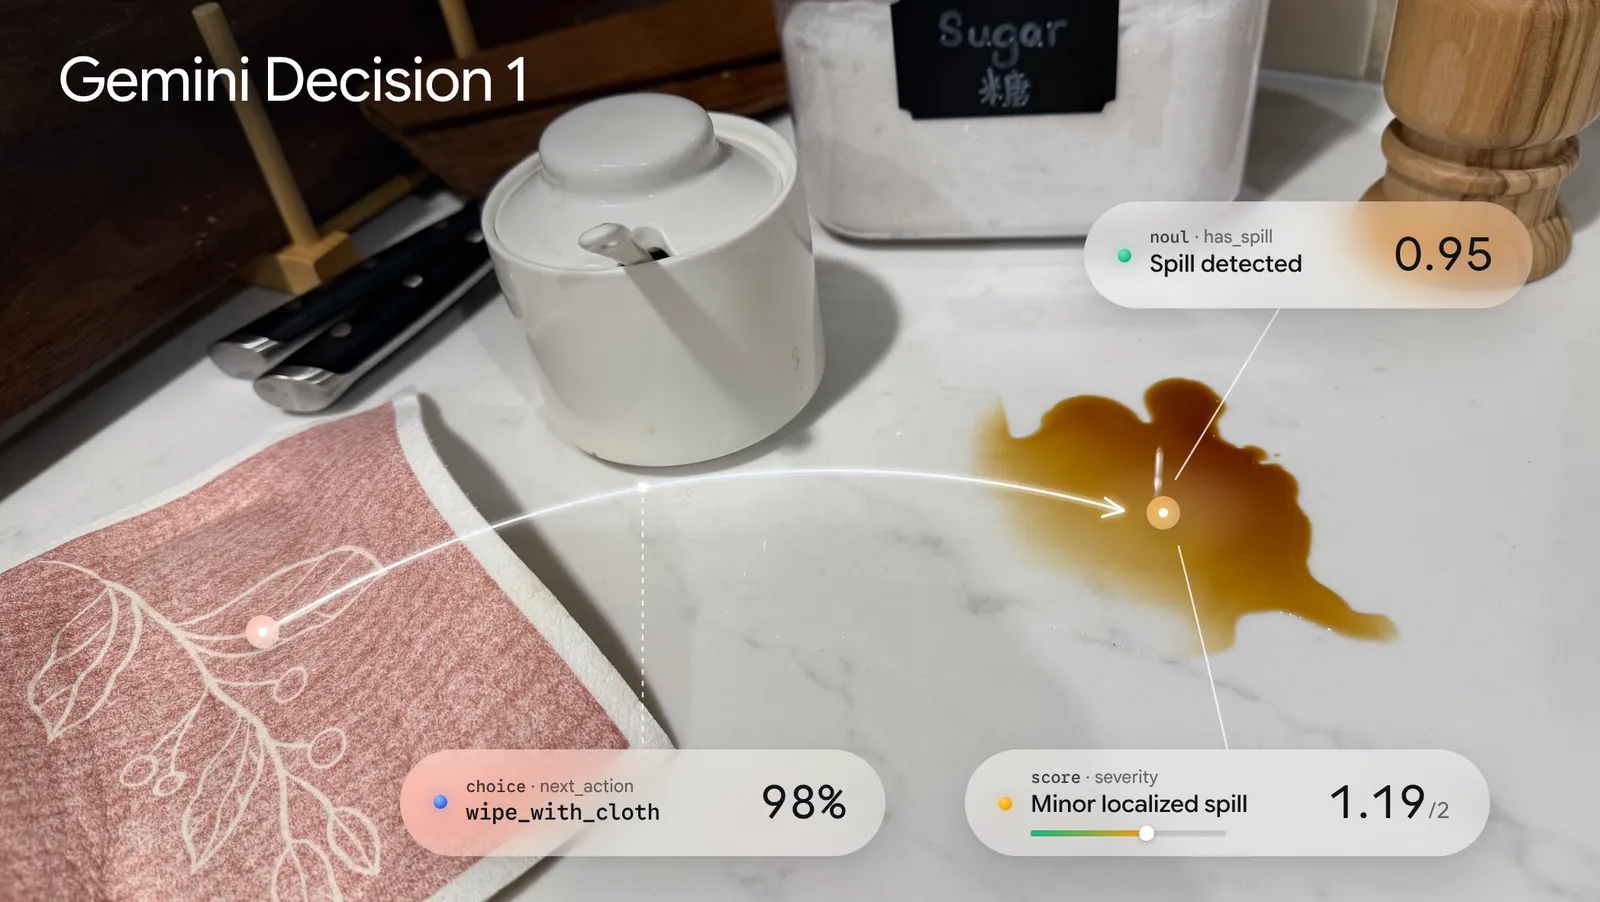
繼 Jev 引發決策模型熱潮後,Google 也加入競爭。Google DeepMind 於 11/11 推出 Gemini Decision 1,以及專門處理分類、評分與選項判斷的 Gemini Decisions API。新模型不以生成文字為主要任務,而是直接針對預設選項進行評分,單次 API 呼叫最多可評估 1,000 項問題,並支援圖片、影音與 PDF 等多模態資料。
今年 9 月,TypeSafe 推出 Jev,讓「決策模型」(Decision Model)受到關注。《科技報橘》先前也曾報導,OpenAI、AWS 與 Cloudflare 陸續投入相關技術,試圖將 AI Agent 的工具選擇、任務分派等工作,從大型語言模型中拆分出來。如今 Google 加入戰局,帶來哪些不同能力?
一次評估千項問題!決策模型延伸至多模態資料
根據 Google 官方公告,Gemini Decision 1 支援三種判斷方式,包括是非題、多選一,以及依照預設標準評分。模型不必像一般大型語言模型逐字生成回答,而是直接計算候選答案的機率,並回傳信心分數,供系統決定下一步行動。
與一般逐次呼叫模型的方式不同,Gemini Decision 1 可以針對同一份輸入資料,一次執行最多 1,000 項獨立判斷,不必為每個問題重新傳送完整資料。對需要同時檢查大量條件的企業而言,這種設計有助於減少重複輸入成本。
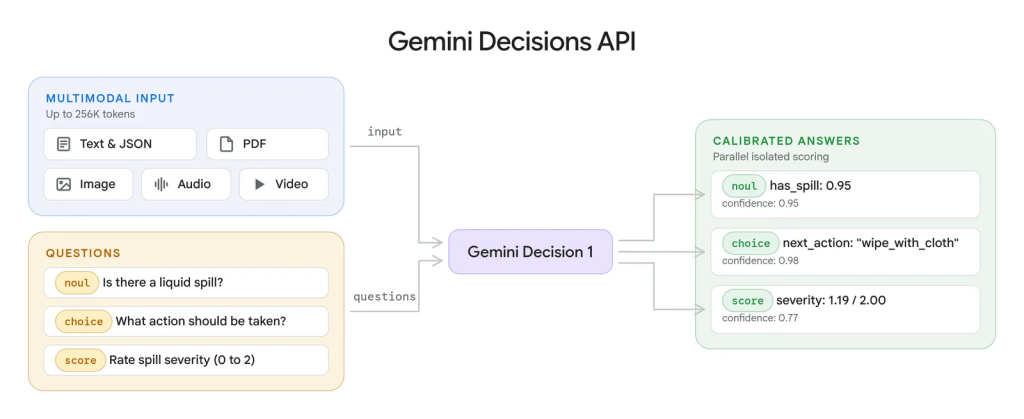
例如保險公司收到理賠申請,可以將申請文件、事故照片及客戶通話錄音一起交給模型,判斷資料是否齊全、案件應分派到哪個部門,以及是否需要人工複核。不過,這裡的 1,000 項問題是各自獨立的判斷,而非連續完成 1,000 步相互依賴的推理。
《VentureBeat》也舉例,假設企業有一份 4,000 tokens 的文件,需要進行 20 項檢查,每項額外使用 50 tokens。若整合成一次呼叫,處理 1,000 份文件的費用約 0.50 美元;如果分成 20 次呼叫、每次重新傳送文件,則約需 8.10 美元。這是依據相同費率推算的假設案例,並非實際企業部署結果,但能說明批次判斷如何降低成本。
Google 表示,Gemini Decision 1 每百萬輸入 tokens 收費 0.10 美元,不另外計算輸出費用。在特定測試條件下,延遲約 150~250 毫秒,測試成本也比 Gemini 3.5 Flash-Lite 低近 5 倍。不過,這些延遲數字主要來自每次 1~100 項問題的測試,不能直接套用到 1,000 題的情況。
不只提供 API,Google 已將決策模型用於自家產品
Google 也開始將這項技術用於實際產品。根據官方說明,Gemini Notebook 已利用 Decisions API 進行模型路由(Model Routing),根據使用者問題的複雜程度,決定應交由哪個模型、使用多高的推理強度處理。
這意味著簡單任務不必每次都動用較耗時的推理模型。Google 宣稱,這套機制可讓日常查詢的延遲最多降低 40%,將較高的運算成本保留給真正需要複雜推理的問題。
另一個應用是安全檢查。Google 表示,Google Search 已使用 Decisions API,偵測模型上下文協定(MCP)工具相關的對抗性行為與惡意內容。
Google 加入戰局,但 Jev 在成本與速度上仍具優勢
Google 雖然加入決策模型競爭,卻不代表 Gemini Decision 1 已全面領先。從功能來看,Jev 1.14 主要支援文字、結構化 JSON,也提供選用的圖片輸入能力;Google 則進一步原生支援音訊、影片與 PDF,讓開發者能整合不同形式的資料。不過,Google 並非首家支援多模態的決策模型,Cloudflare 先前推出的 Clef 也已具備相關能力。
價格方面,根據《The Implicator》整理,Google 每百萬輸入 tokens 收費 0.10 美元,Jev 1.14 則為 0.042 美元。因此,對主要處理文字分類、客服案件分流等任務的企業而言,Google 未必是最便宜的選擇。
效能表現也呈現不同結果。Google 公布的測試顯示,Gemini Decision 1 在 JevBench 取得 92.2% 準確率,高於 Jev 1.14 的 90%;但在評估工具選擇能力的 When2Call 測試中,Jev 以 82% 領先 Google 的 79.9%。
獨立評測機構 Artificial Analysis 的 Decision Index v2.1,則將 Gemini Decision 1 排在 18 款模型中的第 9 名,綜合分數為 65.98,略低於 Jev 1.14 的 66.23。兩者每項任務的測試時間分別為 211 毫秒與 92 毫秒。
更值得企業注意的是文件檢查能力。在 AA-Paperclip 測試中,模型必須針對每份履歷、論文、發票或收據回答 15 個問題,全部正確才算通過。Gemini Decision 1 的完整通過率為 33%,Jev 為 35.5%,而 Drex Max v1.1 達到 63%。
這說明即使模型能一次評估大量問題,也不代表每個檢查項目都能正確完成。對於文件審核、法遵檢查等需要高度準確性的企業應用,除了速度與 API 費率,更應評估模型在實際工作流程中的錯誤率、人工複核需求,以及每件正確完成任務的總成本。
【推薦閱讀】
◆ Jev 為何爆紅?AI Agent 正重新分配「誰來做決策」
◆ Jev 爆紅後 Strands Decider、Clef 接連登場,決策模型正走出哪些不同路線?
◆ AI 不必重新訓練也能修補?MIT 新研究讓 GPT-6 Astra 直接修改 Qwen 權重,數學測試成績提升近 6 倍
*本文開放合作夥伴轉載,資料來源:Google、《VentureBeat》、《implicator.ai》,首圖來源:Google