
一款不會寫文章、不會生成程式碼,甚至不輸出一般文字的 AI 模型,最近正快速受到開發者關注。AI 決策模型新創 TypeSafe AI 在 9/15 推出 Jev 後,36 小時內便讓約 14 萬名候補使用者取得資格;初期需求一度讓官方 API 無法正常服務,Cloudflare、LangChain、Langfuse 等開發工具也迅速加入支援。
Jev 的特殊之處,正是刻意放棄文字生成。TypeSafe 將這類專門為軟體決策打造的模型稱為「系統一模型」(System One Models),Jev 則是第一款公開模型。名稱取自《快思慢想》的 System 1 概念,強調快速、直覺式判斷,而非較慢的逐步推理。《TechCrunch》形容,Jev 側重快速、直覺式判斷,而不是長步驟推理,因此把能力集中在分類、選擇、評分等範圍明確的任務。
這個方向也來自創辦人 Diogo Almeida 對聊天模型的反思。他過去曾參與 OpenAI 讓大型語言模型(LLM)更會遵循指令、與人互動的研究,但後來認為,現有模型雖已非常擅長人類語言,卻未必適合軟體自動化。他將問題歸因於模型主要為人類語言最佳化,而電腦實際需要的是不同形式的輸出。
Jev 如何把複雜資訊,直接變成軟體能使用的決策?
Jev 和一般生成式模型最大的差別,就在於直接把輸入資訊轉成程式可以使用的「決策」。TypeSafe 將 Jev 的輸出限制在 3 種形式:Noul(是非判斷)回答「是或否」並給出機率;Choice(選項判斷)從預先設定的選項中選擇,並提供各選項的機率分布;Score(評分)則在指定尺度上給出分數。
例如,AI 代理(AI Agent)可以問 Jev「這項操作是否安全」、「下一步該使用哪個工具」,或「這筆交易的風險有多高」。Jev 不會先生成一段解釋,而是直接回答是或否、選哪一個,或給出分數,讓程式依結果決定下一步。這種設計的好處,是可能答案與輸出格式事先就已確定,程式不用再從一段自然語言裡解析模型到底想做什麼,還可以依照機率或信心程度設定後續規則。例如信心很高時直接執行,結果模糊時改交另一個模型或轉由人工確認。
TypeSafe 的工作流程測試也採取類似思路:把複雜工作拆成多個範圍明確的判斷,只把需要語意理解的部分交給模型,能以確定性規則處理的部分則留給程式碼。官方表示,在 4 種測試工作流程中,這種方式平均都比把同一套規則一次寫進提示詞(prompt)、交由模型處理更準、更快,也更便宜。
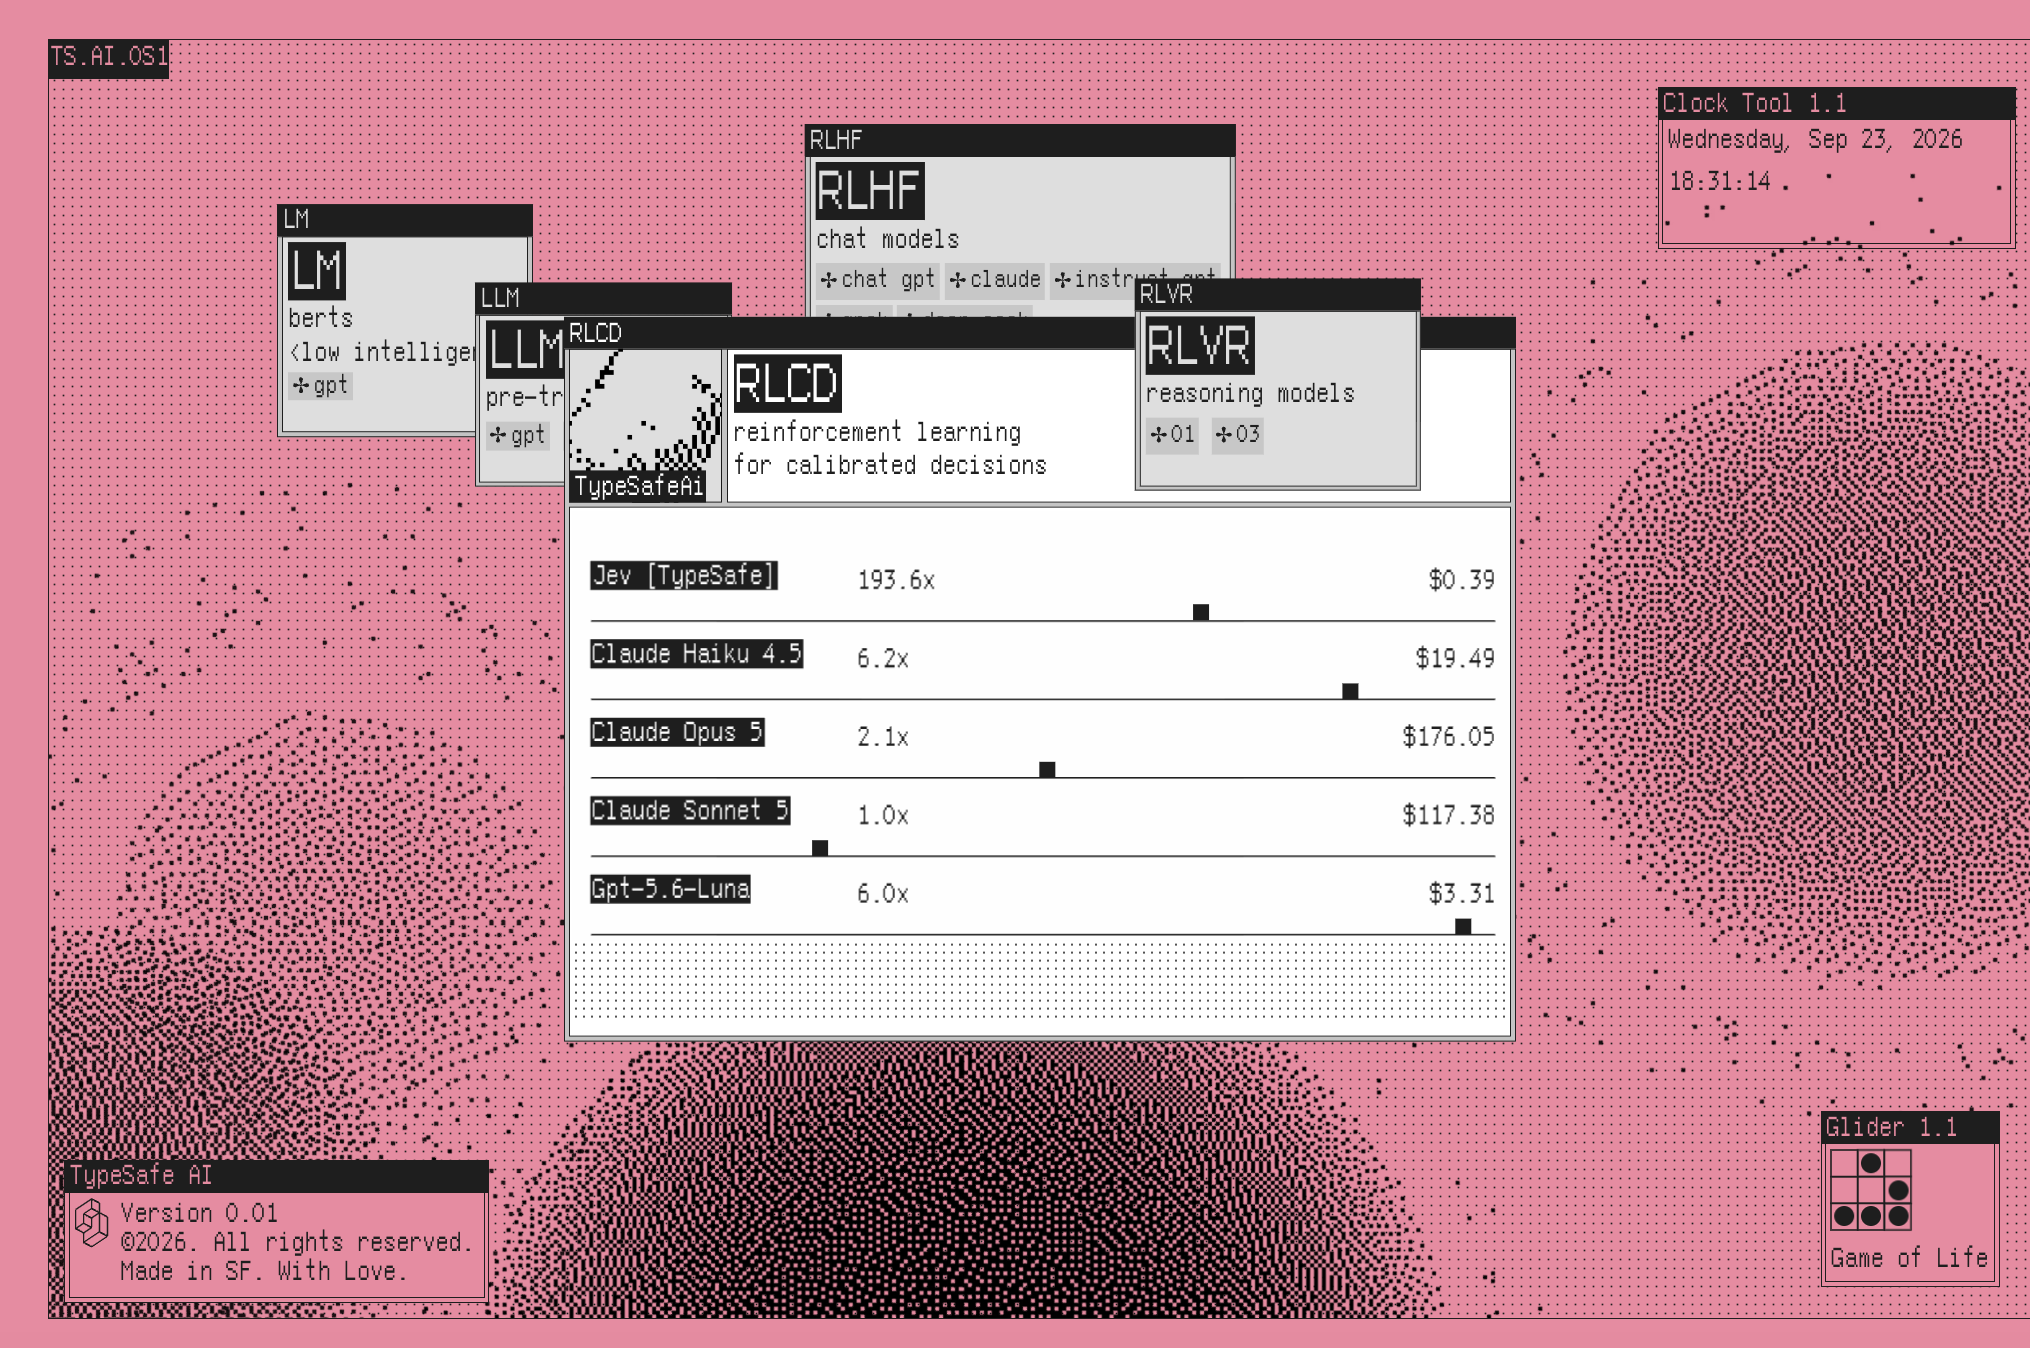
放棄逐字生成,也換來速度與成本優勢。TypeSafe 自家測試宣稱,Jev 在系統一工作流程中最高可快 193.6 倍、便宜 444.6 倍,但該公司也承認這些數字可能位於實際效益的高端。外部開發者也開始相關測試,Vercel 工程師把原本交給大型模型的安全分類工作改用 Jev,速度提高 5 至 18 倍;Bryo AI 技術長 Nikhil Mudholkar 則以 Jev 和 Google Gemini 分類商業郵件,發現 Gemini 的準確率略高,但每次分類成本是 Jev 的 10 至 20 倍。
Jev 的命名取自「傑文斯悖論」(Jevons paradox):當一項資源使用成本下降,總需求反而可能增加。Almeida 對《TechCrunch》表示,他預期未來「智慧軟體」會更分散地出現在各種地方,形態更接近早期網路,而非集中在少數大型 AI 應用。
換句話說,如果一次 AI 判斷變得足夠便宜,它就可能被放進更多軟體流程,甚至一項工作裡的每個小步驟。這也是 Jev 的速度與成本,在 AI 代理情境特別受到注意的原因。
當 AI 代理一次要做大量判斷,LLM 還適合包辦每一步嗎?
AI 代理不只在最後生成一次答案,為了完成一項工作,它可能需要不斷判斷該使用哪個工具、資訊是否足夠、某項操作是否安全、下一步該做什麼,以及任務是否需要交給更強的模型。
其中不少問題其實只有有限答案,卻可能各自消耗一次完整的大型語言模型(LLM)呼叫。《InfoWorld》引述獨立科技顧問 David Linthicum 指出,當單一 AI 代理任務觸發多次模型呼叫,每一個決策都使用通用大型模型,成本與延遲很快就會累積。
《TechCrunch》也以模型路由(model routing)為例。開發者 Armin Ronacher 指出,判斷一項任務究竟該交給哪個模型很有價值,但如果光是做這項判斷,就得先呼叫一次昂貴的大型模型,路由本身反而可能不划算。
因此,Jev 真正引人注目的不只在模型本身,開發者開始拿它處理分類、路由、工具選擇,以及判斷某項操作能否執行等原本也大量交給大型模型的工作。
把「決策」拆出去後,AI 代理會怎麼分工?
Jev 不一定要取代大型模型,更可能被放在旁邊分工。《InfoWorld》引述 Linthicum 指出,Jev 這類決策模型更可能與通用大型模型並存:大型語言模型負責開放式推理、摘要與互動,決策模型則處理路由、評分、驗證、政策檢查等頻繁、輸出範圍又較明確的判斷。
這代表 AI 代理的設計可能不再預設「一顆大型模型包辦所有工作」,而是依任務特性分配不同工具:確定性的流程交給程式碼,快速、有限範圍的判斷交給決策模型,真正需要複雜推理與生成時,再動用大型語言模型。
當決策模型直接左右 AI 代理行動,新的風險在哪裡?
然而,決策從大型模型拆出去,可靠性問題仍然存在。《VentureBeat》指出,當 Jev 開始被放進 AI 代理流程,決定該使用哪個工具、某項操作能否執行,模型能看到哪些資訊也開始變得重要。
Python 常用的開源資料驗證工具 Pydantic,其團隊已在旗下 AI 代理開發框架 Pydantic AI 整合 Jev,但也提醒,Jev 會把輸入內容當成待判斷的資料,因此刻意設計的惡意文字仍可能影響模型結果。TypeSafe 自己也承認,提示詞注入(prompt injection)或具有誤導性的描述可能改變答案。
已經有開發工具開始調整做法。LangChain 利用 Jev 判斷 AI 代理提出的工具呼叫能否執行時,刻意排除工具回傳內容,避免 AI 代理從外部取得的文字反過來影響「自己能不能執行」的判斷;涉及重要操作時,也建議保留人工核准。
此外,Jev 的輸出範圍事先受到限制,也不代表判斷一定正確。答案即使只有 A、B、C,它仍可能選錯。Pydantic 因此建議,這類 AI 判斷應與確定性檢查並存,而不是直接取代既有的權限限制與人工審查。
Jev 推出時間仍短,目前的熱度還不足以證明「決策模型」會成為長期獨立的模型類別。但它快速受到開發者關注,至少反映 AI 代理發展正在出現一項變化:當一項工作需要的 AI 判斷越來越多,問題逐漸不只是哪顆大型模型最強,而是生成、推理、路由與決策,究竟各自應該交給誰。
科技的變化總是快得驚人,而我們每天的工作,就是從龐雜的趨勢中理出觀點、提煉出決策者真正需要的洞察。如果你也對 AI 發展充滿熱情,《TechOrange 科技報橘》正在徵內容編輯!
👉了解職缺內容
【推薦閱讀】
◆ Anthropic、OpenAI 同日推 Opus 5.5、GPT-6 Sol/Luna:最高階 AI 能力正以幾週速度往下放
*本文開放合作夥伴轉載,資料來源:TypeSafe 1、TypeSafe 2、《TechCrunch》、《InfoWorld》、Vercel、《VentureBeat》,首圖來源:TypeSafe