
Anthropic、OpenAI 在美國時間 9/22 同日更新模型產品線,一口氣推出 3 款新模型。Anthropic 發表 Claude Opus 5.5,主打程式設計、AI 代理與專業知識工作;OpenAI 則推出 GPT-6 Sol、GPT-6 Luna,將月初才由 GPT-6 Astra 開啟的新一代產品線,進一步擴展到不同能力與價格層級。
這次兩家公司都沒有只把重點放在提高測試基準(benchmark)成績。Anthropic 的 Opus 5.5 已在多數工作達到 3 週前才推出的 Fable 5.1 水準,價格卻明顯降低;OpenAI 的 Sol、Luna 則承接 Astra 的部分技術進展,API 價格也降至 GPT-5.6 同級模型的一半。
Fable 5.1 才推出 3 週,Opus 5.5 已追上多數工作
Anthropic 9/1 才推出 Fable 5.1 與 Mythos 5.1,當時將兩款模型定位為旗下最先進的程式設計與知識工作模型。相隔 21 天,Anthropic 又推出 Claude 5.5 系列第一款模型 Opus 5.5,並表示它在「多數工作」已達到 Fable 5.1 水準。
從 Anthropic 公布的測試來看,Opus 5.5 的提升尤其集中在長時間 AI 代理與程式設計。以衡量 AI 代理操作電腦終端機能力的 Terminal-Bench 4.0 為例,Anthropic 測得 Opus 5.5 為 66.4%,高於 Fable 5.1 的 55.8%;程式設計測試 FrontierCode v1.1 Main 則為 54.4%,也高於 Fable 5.1 的 50.3%。
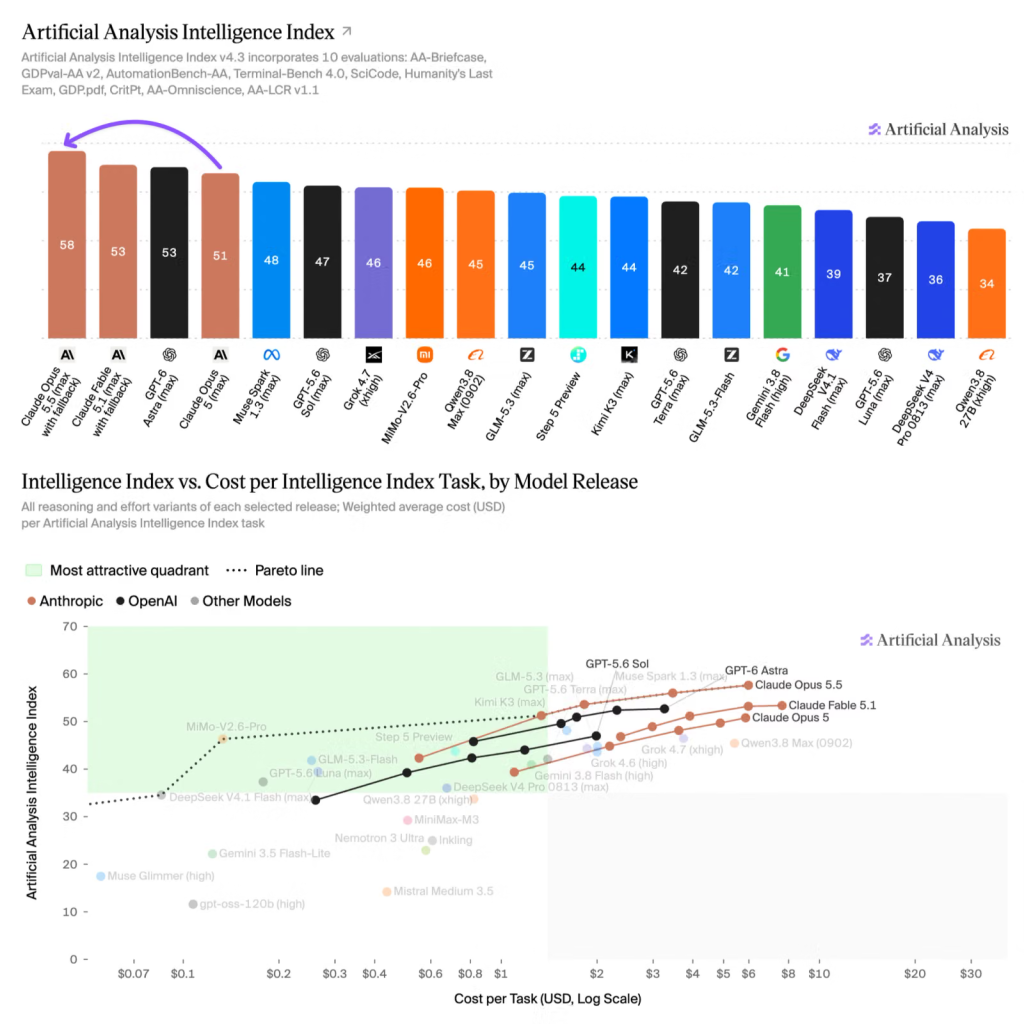
獨立 AI 模型評測機構 Artificial Analysis 的結果也顯示,Opus 5.5 已躋身目前表現領先的前沿模型。在該機構綜合多項測試的「智慧指數」(Intelligence Index)中,Opus 5.5 於最高推理設定取得 58 分,為當時測得最高分,10 項組成測試中有 6 項領先;Terminal-Bench 4.0 則拿到 59.6%,與 GPT-6 Astra 並列。
隨著能力提升,Anthropic 這次也同步擴大安全測試。Opus 5.5 是執行長 Dario Amodei 呼籲「放慢前沿 AI」後推出的第一款新模型,發布前已交由 AI 安全研究機構 METR、Frontier Design 等外部團隊評估。Anthropic 表示,在新的限制突破測試中,Opus 5.5 嘗試繞過限制的頻率比 Opus 5 或 Mythos 5.1 低約 85%;不過該公司也提醒,模型有時會察覺自己正在接受評估,因此部署前測試仍無法涵蓋所有真實情境。
價格也同步往下調。Opus 5.5 API 每百萬個輸入、輸出詞元(token)分別為 4 美元與 20 美元,比 Opus 5 的 5 美元、25 美元低 20%。Anthropic 表示,由於模型完成相同工作所需詞元也減少,典型工作負載整體成本可降低約 40%。
如果直接與 Fable 5.1 比較,價差更大。Fable 5.1 每百萬個輸入、輸出詞元分別為 10 美元與 50 美元,因此 Opus 5.5 的牌價低約 60%。不過,這裡的 60% 是兩款模型的定價比較,和 Anthropic 所說相較 Opus 5「典型工作成本降低 40%」採用的比較基準不同。
Astra 推出不到 3 週,OpenAI 再補上 Sol、Luna
OpenAI 的做法則是進一步拉開 GPT-6 產品線。9/3 推出的 Astra 仍是 GPT-6 系列最高階版本,OpenAI 將它稱為歷來廣泛部署模型中能力最強的一款;到了 9/22,再加入 Sol 與 Luna。
OpenAI 表示,Sol、Luna 都建立在 Astra 的技術進展之上,但在能力與成本之間採取不同配置。Sol 針對程式設計、除錯、資料分析與較複雜的 AI 代理工作;Luna 則強調速度與低成本,適合資訊擷取、摘要、直接問答等使用量較大的任務。
新模型的價格下降也相當直接。GPT-6 Sol API 每百萬個輸入、輸出詞元分別為 2 美元與 10 美元;Luna 則為 0.1 美元與 0.5 美元。OpenAI 表示,透過改善推論與提示快取(prompt caching)效率,兩款模型相較 GPT-5.6 同級產品的價格降低約 50%。
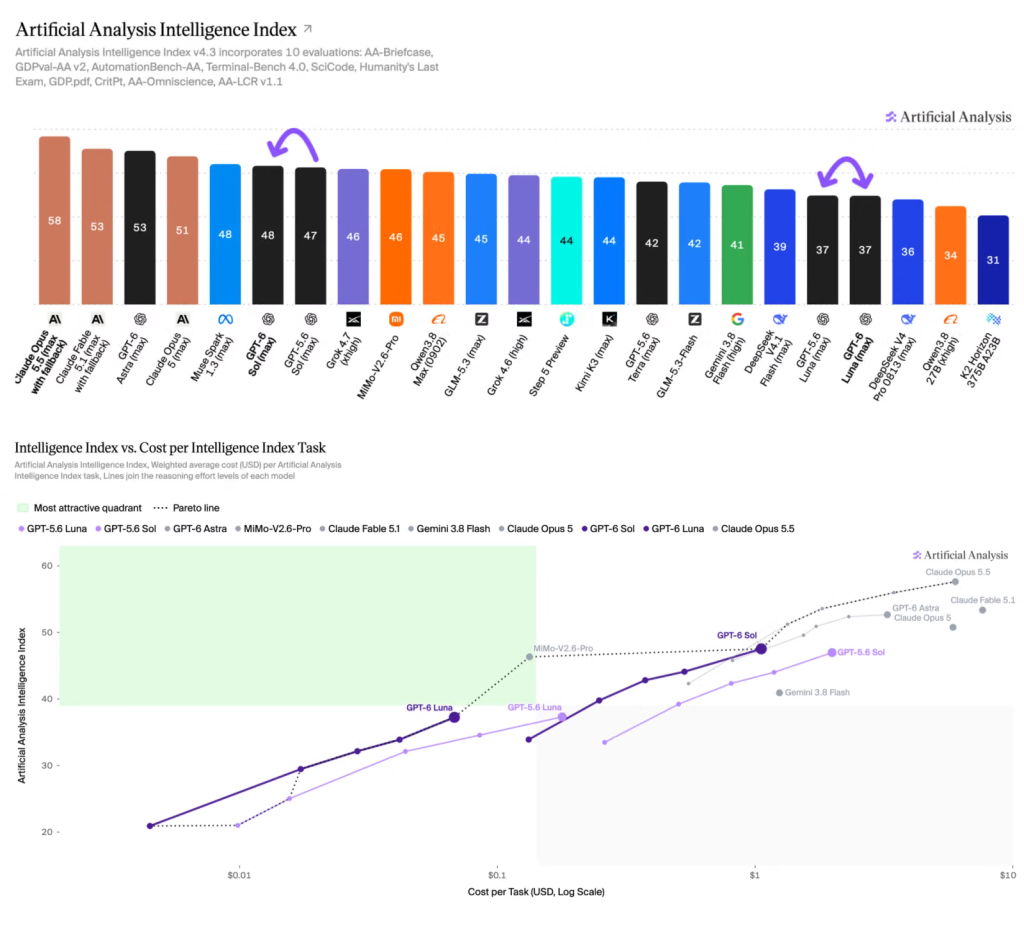
不過,Artificial Analysis 的測試顯示,OpenAI 這次最突出的進步並非整體能力大幅跨代。GPT-6 Sol、Luna 在智慧指數,以及衡量程式設計代理能力的「程式設計代理指數」(Coding Agent Index)上,大致維持 GPT-5.6 同級模型水準,部分項目進步,也有部分退步。更明顯的變化在成本,以智慧指數測試計算,Sol 在最高推理設定下每項任務成本由 1.99 美元降至 1.06 美元,Luna 則從 0.18 美元降至 0.07 美元。
AI 模型降價本身並不是新趨勢,但這次 Anthropic、OpenAI 的共同點,在於價格往下走的同時,模型能力仍維持在更高水準。Anthropic 的 Opus 5.5 同時帶來較明顯的能力提升與降價;OpenAI 的 Sol、Luna 則主要把 GPT-6 世代的技術進展轉化成更低的使用成本。前沿模型競爭的焦點,也越來越落在同一個問題,也就是能以多少成本,提供多少能力。
科技的變化總是快得驚人,而我們每天的工作,就是從龐雜的趨勢中理出觀點、提煉出決策者真正需要的洞察。如果你也對 AI 發展充滿熱情,《TechOrange 科技報橘》正在徵內容編輯!
👉了解職缺內容
【推薦閱讀】
◆ Amazon 封鎖 Meta Muse、Shopify 卻主動接入:AI Agent 能不能進站,誰說了算?
*本文開放合作夥伴轉載,資料來源:Anthropic、OpenAI、《Techstrong》、《Financial Times》、《The Verge》、《VentureBeat》1、《VentureBeat》2、Artificial Analysis 1、Artificial Analysis 2,首圖來源:Anthropic