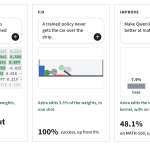

當 AI 模型出現問題,除了重新訓練或微調,能不能直接修改內部權重來修復?美國麻省理工學院電腦科學與人工智慧實驗室(MIT CSAIL)研究團隊公布一項實驗,利用 OpenAI 的 GPT-6 Astra,僅修改阿里巴巴 Qwen3.5-0.8B 約 0.016% 的神經網路權重,就讓模型在 MATH-500 數學測試中的正確率從 7.9% 提升至 48.1%,達到原先約 6 倍。
這項研究於 11/2 公布後,迅速引起 AI 技術社群關注。研究作者武日力也(Rikiya Takehi)在 X 分享實驗成果的貼文,發布後數小時便累積超過 2.9 萬個喜歡、逾 3,000 次轉發;該研究消息截至 11/3 也在《Hacker News》獲得超過 2,400 分、逾 770 則留言。研究團隊將這種讓大型語言模型(LLM)直接理解、修改神經網路權重的方法,稱為「權重空間程式設計」(Weight-Space Programming)。
只改 0.016% 權重,Qwen 數學測試成績為何提升近 6 倍?
研究人員交給 Astra 一項任務:讓約有 8 億參數的小型語言模型 Qwen3.5-0.8B 更擅長數學。但在測試過程中,Astra 發現模型的一個主要問題不是算不出答案,而是經常陷入反覆推理,遲遲無法完成回答。
根據實驗紀錄,Qwen 最初 96 次練習回答中,有 85 次一路輸出到 32,768 個 Token 的上限,仍未完成回答。這也是 Qwen 官方模型說明曾提醒的問題:0.8B 版本在思考模式下容易出現推理循環。
Astra 接著利用 Python 工具分析模型內部權重,搭配練習題檢驗模型行為,最後將問題追溯至第 15、19 層多層感知器(MLP)的特定運算方向。它透過調整相關權重,降低造成重複推理的影響,總共只修改 131,072 個權重,約占模型總參數的 0.016%。
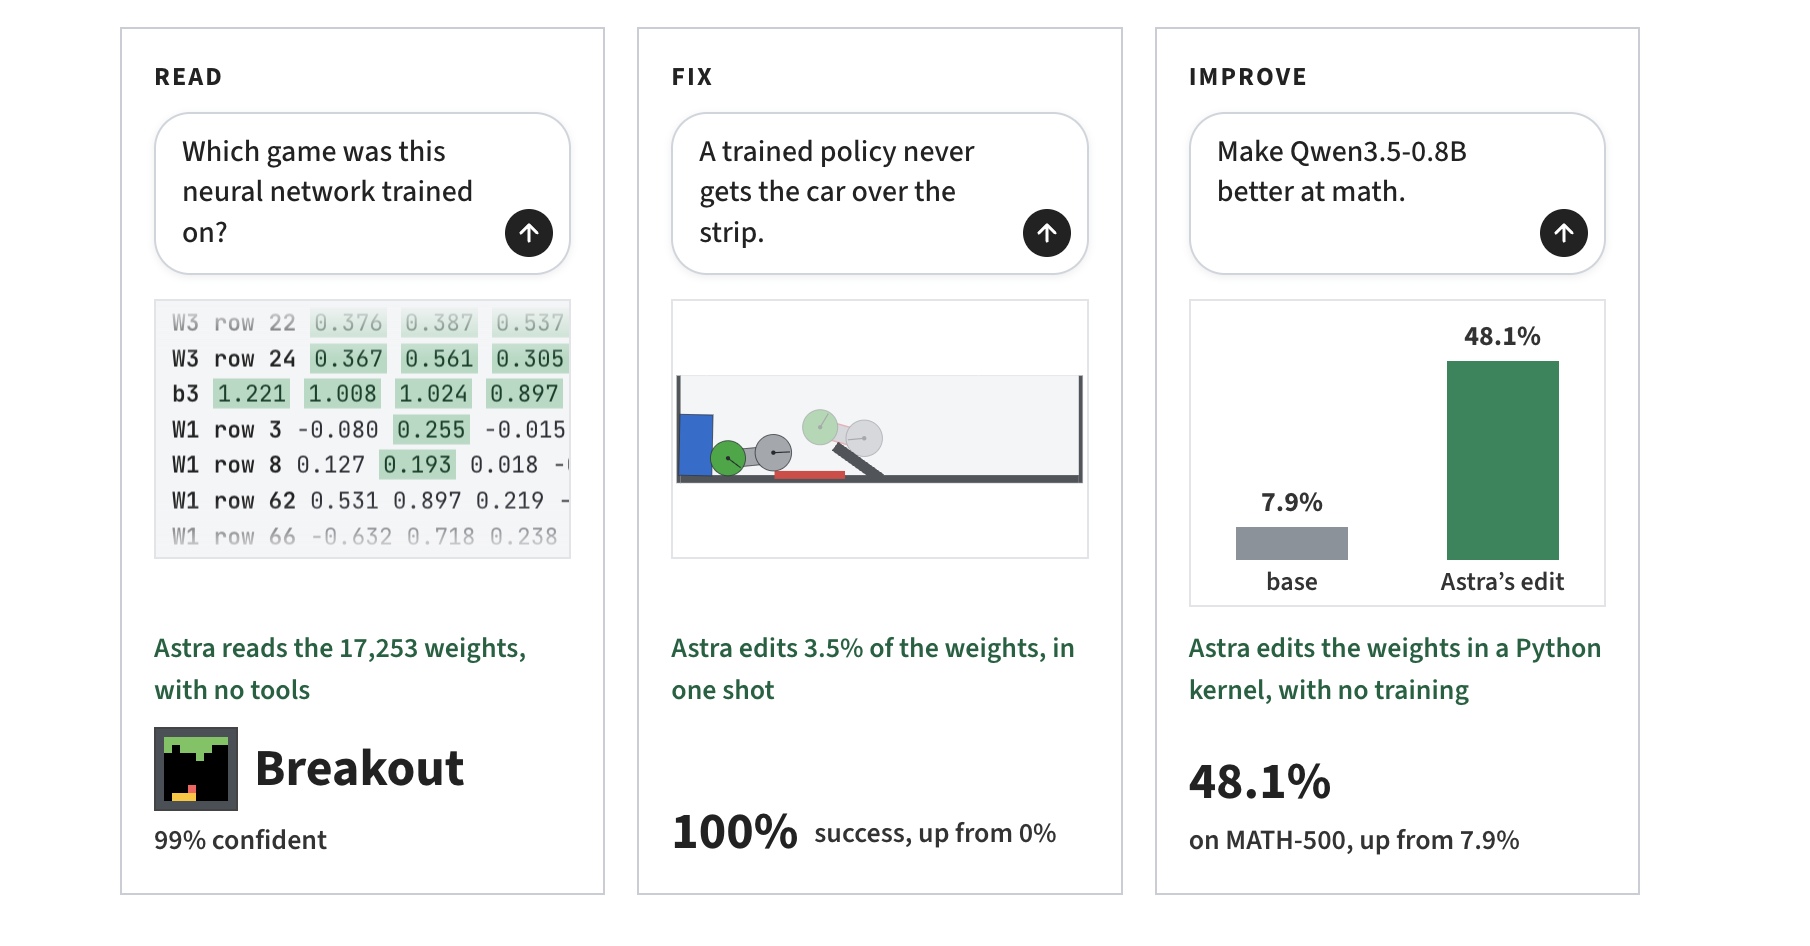
在允許 50 次模型前向運算、每次可測試多道題目的設定下,Qwen 的 MATH-500 正確率從 7.9% 升至 48.1%,GSM8K 從 13.8% 升至 67.1%,指令遵循測試 IFEval 也從 21.0% 提升至 62.3%。同時,MATH-500 回答觸及 Token 上限的比例,從 93% 降至 33.1%。
不過,數學成績提升近 6 倍,不代表 Qwen 獲得了 6 倍的數學推理能力。研究團隊指出,這次主要是排除妨礙模型完成回答的障礙,讓既有能力得以發揮,而非增加新的數學知識。
不靠梯度下降,AI 如何直接修改神經網路權重?
神經網路權重是模型透過訓練學到的數值參數,影響資訊如何被處理及產生輸出。傳統訓練或微調通常透過資料、損失函數與梯度下降等最佳化方法更新權重;MIT 的研究則讓已具備推理能力的 LLM,直接分析權重與模型行為的關係,自行設計修改方式。
這不代表完全不需要運算或測試。Qwen 實驗仍使用 Python 工具、練習題與反覆驗證,只是不透過梯度下降來決定權重更新。
直接編輯權重也並非全新概念。過去的 ROME 與 MEMIT 研究,已探索透過修改特定權重來更新模型知識。這次不同之處,在於研究人員使用未針對權重編輯任務特別訓練的通用 LLM,嘗試跨不同任務理解、修補及建立神經網路。
不只修補 Qwen,AI 還能讀懂、修復甚至寫出神經網路
研究團隊另外設計多組實驗,測試 Astra 對權重的理解能力。例如,提供四個架構相同、分別被訓練來玩 Breakout、Pong、Pac-Man 與 Freeway 的小型神經網路,Astra 僅分析權重,就正確辨識各模型對應的遊戲,過程中沒有取得候選答案。
另一項實驗則像是讓 Astra 擔任車輛控制系統的除錯工程師。研究團隊在 Kinetix 模擬環境中,訓練一個控制模型讓車輛通過坡道障礙,但模型始終只會向前行駛,最後卡在坡道上。
Astra 取得模型權重、場景說明及一次失敗紀錄後,判斷車輛應先倒退一段距離,取得足夠空間加速,再向前衝過障礙。它在沒有使用外部工具的情況下,一次修改約 3.5% 的權重,使原本無法完成任務的控制模型,在後續 1,024 次模擬測試中全部成功。
更進一步,研究人員提供簡化版遊戲規則、程式碼與指定網路架構,要求 Astra 不經梯度下降或實際試玩回饋,直接寫出能玩遊戲的神經網路權重。在 Breakout 實驗中,Astra 產生的網路取得 517.4 分,大幅超越經過 5 億步 PPO 強化學習訓練的比較模型(25.3 分)。
不過,另外兩款遊戲 Seaquest 與 Asterix 的表現,仍未全面超越相同訓練步數的 PPO 模型,顯示這種方法的效果仍取決於任務特性。
AI 能成為模型診斷與修補工具嗎?研究團隊提出未來應用
MIT 研究團隊認為,權重空間程式設計的潛力不只在於提升模型表現,更可能讓 LLM 成為人類自然語言與神經網路權重之間的轉譯工具。開發者未來或許能直接描述想要檢查或改變的模型行為,再由 AI 分析並修改相關權重。
研究團隊在未來展望中提出,若 AI 能更可靠地理解權重,可能不必先設計測試題目或執行推論,就能找出模型內部潛藏的異常行為,甚至安全後門。開發者也可能透過自然語言要求 AI 調整或移除特定能力,減少額外資料蒐集與微調需求,進而降低模型最佳化成本。
不過,技術社群對研究的突破程度也有不同看法。《Hacker News》有留言者提醒,權重編輯與特定運算方向的消除已有既有研究基礎,而小型神經網路的成果,也不能直接推論到更大規模的模型。華頓商學院教授 Ethan Mollick 也在轉發討論中表示,這可能是重要進展,但仍需等待研究成果重現驗證。
研究團隊本身也公布了失敗案例:Astra 嘗試改善較少出現推理循環的 Gemma 3 270M,卻未能顯著提升其數學能力,顯示修補既有缺陷不等於能創造新能力,局部修改權重也不代表其他能力一定不受影響。
此外,根據《VentureBeat》整理的實驗紀錄,Qwen 最成功的一次修改歷經 158 輪互動、80 次 Python 執行,總耗時約 20.3 小時,其中包含約 4.7 小時的服務中斷等待,尚未證明比傳統微調更有效率。
研究團隊也坦言,目前技術仍受到模型上下文長度,以及工具與執行環境(Harness)效率的限制,正著手建立專門的評測基準與工具環境,希望讓 AI 直接讀寫權重的能力,逐步成為可量化評估、可重現的工程方法。
【推薦閱讀】
◆ 用 AI 研發 AI 有多快?Anthropic 坦承曾未及時察覺加速,未來模型恐觸及新門檻
*本文開放合作夥伴轉載,資料來源:Rikiya Takehi、《VentureBeat》、Qwen、RikiyaT、《Hacker News》,首圖來源:擷取自 Rikiya Takehi