
阿里巴巴 11/16 發表新旗艦模型 Qwen4-Max,稱它是千問(Qwen)家族迄今能力最強的模型。阿里巴巴依自家測試指出,和前代 Qwen3.8-Max 相比,Qwen4-Max 每項任務的平均成本降低約六成;官方也拿它和 Anthropic、OpenAI 的旗艦模型比較,16 項測試中有 6 項領先 Claude Opus 5.5。
阿里巴巴主打的,不只是每百萬 token 的單價,而是完成一項任務要花多少錢。不過,廠商在自家測試中算出的成本,能不能代表企業實際拿到的帳單?企業評估或更換模型時,又該把哪些成本算進去?
啟用參數少四分之一、API 降價,Qwen4-Max 和美國旗艦模型比互有勝負
Qwen4-Max 採用混合專家(Mixture of Experts, MoE)架構:模型內有許多「專家」子網路,每次只叫用其中一部分,總參數大,每次的運算量卻較小。Qwen4-Max 總參數 2.4 兆,每個 token 只啟用 710 億參數;阿里巴巴表示,在同為 2.4 兆的規模下,啟用參數比 Qwen3.8-Max 少 25%。官方也稱,它具備原生視覺能力,支援 100 萬 token 的上下文視窗(context window,模型一次能讀進的內容長度)。
Qwen4-Max 的成本數字,出自阿里巴巴自建的基準測試 Work360,涵蓋 721 個專業領域的高難度產業任務。官方指出,在高強度(High)推理模式下,Qwen4-Max 整體表現勝過前代,token 用量約少 35%,每項任務平均成本降約六成。
據《InfoWorld》報導,Qwen 團隊估算的每項任務平均成本,從 Qwen3.8-Max 的 4.43 美元降到 Qwen4-Max 的 1.67 美元。阿里巴巴把這筆節省歸因於 token 用量減少與 API 新定價:每百萬輸入 token 從 2 美元降為 1.50 美元,輸出從 6 美元降為 4.50 美元。
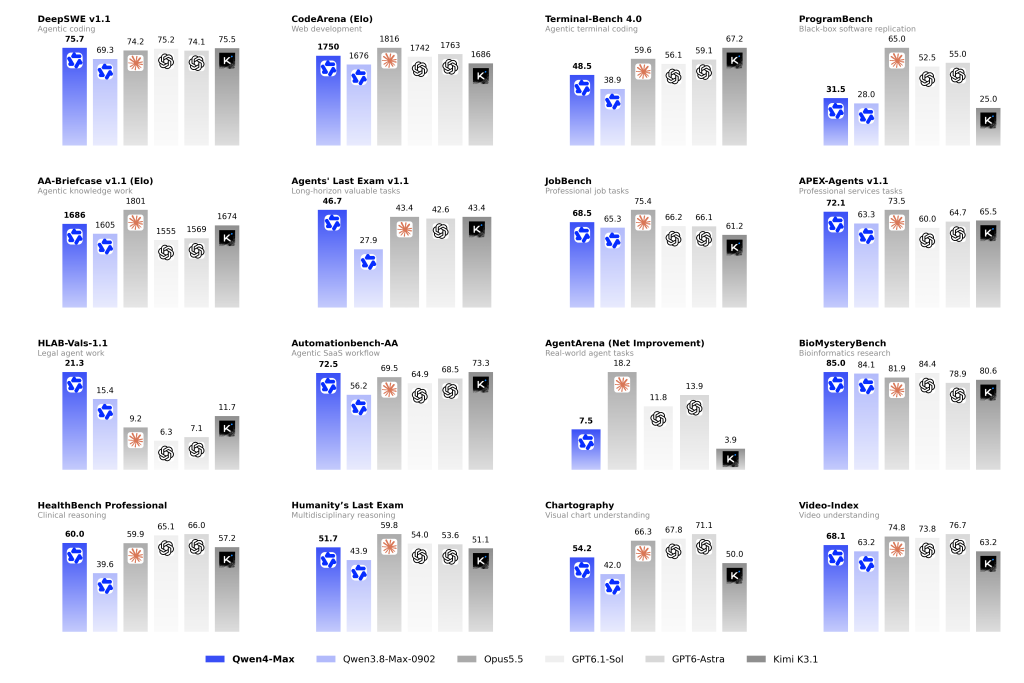
和美國模型相比,結果則互有勝負。依 Qwen 官方部落格的比較圖,Qwen4-Max 在 16 項測試中有 6 項分數高於 Claude Opus 5.5,包括代理式程式開發測試 DeepSWE v1.1(75.7 對 74.2);其餘 10 項落後,例如終端機程式任務測試 Terminal-Bench 4.0(48.5 對 59.6)。阿里巴巴另表示,Qwen4-Max 在真實程式開發排行榜 Code Arena 排名第 6。官方圖表的說明,重點仍放在和前代相比「整體能力顯著提升」。
據《The Business Times》報導,千問系列是全球下載量最高的開放權重模型家族,但阿里巴巴這次沒有開放 Qwen4-Max 的權重,企業只能透過 QwenCloud 等阿里巴巴的雲端服務使用;公司表示,Qwen4 系列較小的開放權重模型將陸續釋出。
廠商數字不等於企業帳單,專家建議用 1,000 項真實任務實測
研究顧問公司 Greyhound Research 首席分析師 Sanchit Vir Gogia 接受《InfoWorld》訪問,評論 Qwen4-Max 的成本數字時形容:「阿里巴巴公布的,是它在自己的路上跑出的里程數;買家的帳單,取決於買家自己開的路。」他建議,企業該衡量的是每個可接受結果的成本,把重試、推理 token,以及員工檢查輸出所花的時間都算進去。
官方數據也顯示,省下多少 token 會隨推理強度而變:Qwen 官方部落格指出,Xhigh 檔位相較前代約減 24%,節省幅度小於 High 檔位的約 35%。資安公司 Security Brigade 創辦人兼技術長 Yash Kadakia 則建議,不要只比每百萬 token 的單價:「企業應該實測,成功完成 1,000 項真實商業任務要花多少成本。」
阿里巴巴也以製造業案例說明人工時間的變化。Qwen 官方部落格提到,在三丰智能裝備、統聯精密的汽車製造生產場景,單一工件的加工編程人工投入,從約 475 分鐘縮短到 24 分鐘,減少約 95%;不過這是公司自行展示的單一案例,未經第三方驗證。
導入中國模型前,資料管轄、內容立場與資安驗證也要列入評估
在中國 AI 業者陸續提高安全測試揭露之際,阿里巴巴這次也說明了安全措施:訓練時依任務意圖過濾資料,保留漏洞偵測與修補等防禦性內容,排除用來提升攻擊能力的資料;在 Last Secure Code Bench 測試中,函式、檔案與軟體儲存庫三個層級都產生安全程式碼的比例,也從前代的 8% 升至 14.7%。《Reuters》註明,這些結果未經其獨立驗證。
外部專家仍建議審慎看待。Gogia 認為,在政府評測單位或具公信力的外部紅隊(模擬攻擊者、找出系統弱點的測試團隊)實測之前,阿里巴巴的安全宣稱應視為承諾。Kadakia 則指出「攻擊和防禦的知識,大致上是同一套知識」,質疑靠過濾訓練資料能否可靠切開兩者。對於 Qwen4 系列日後釋出的開放權重模型,他提醒「安全訓練不是模型永久的屬性」,企業微調後要重新做對抗測試,並控管工具存取權限。
資料管轄同樣是評估重點。Gogia 建議非中國企業評估阿里巴巴全球服務的地理範圍、提示詞保存政策與資料管轄權,並指出提示詞最長保存 30 天,被標記的內容保存更久。台灣國安局去年抽測 5 款中國生成式 AI App,通義千問 App 在 15 項資安指標中違反 11 項,是 5 款中最多;國安局也指出,這些 App 談到兩岸、南海等議題時,會呈現中共官方立場。不過,受測的是消費端 App,不是 Qwen4-Max 的 API。
Qwen4-Max 把比價的單位,從每百萬 token 單價拉到每項任務成本;但阿里巴巴公布的成本與安全數據,多來自自家測試,仍有待外部驗證。依兩位專家的建議,企業比較模型時,可以用自己的真實任務實測,把重試、人工檢查,以及資料管轄與安全驗證的成本一併算進帳單。
【推薦閱讀】
◆ Qwen3.8 試圖連往阿里雲,是後門還是訓練殘留?企業部署 AI 代理先管住對外連線
◆ Qwen 追近前沿、DeepSeek 任務成本僅約 Claude 的 1%,Hugging Face 執行長:中國明年若主導前沿模型也不意外
◆ 聯準會盤點 AI 資料中心融資:發債 3 年增至 5 倍,風險落在誰身上?
*本文開放合作夥伴轉載,資料來源:Alibaba Cloud、Qwen、《InfoWorld》、《Reuters》、《The Business Times》、《聯合報》,首圖來源:Qwen