
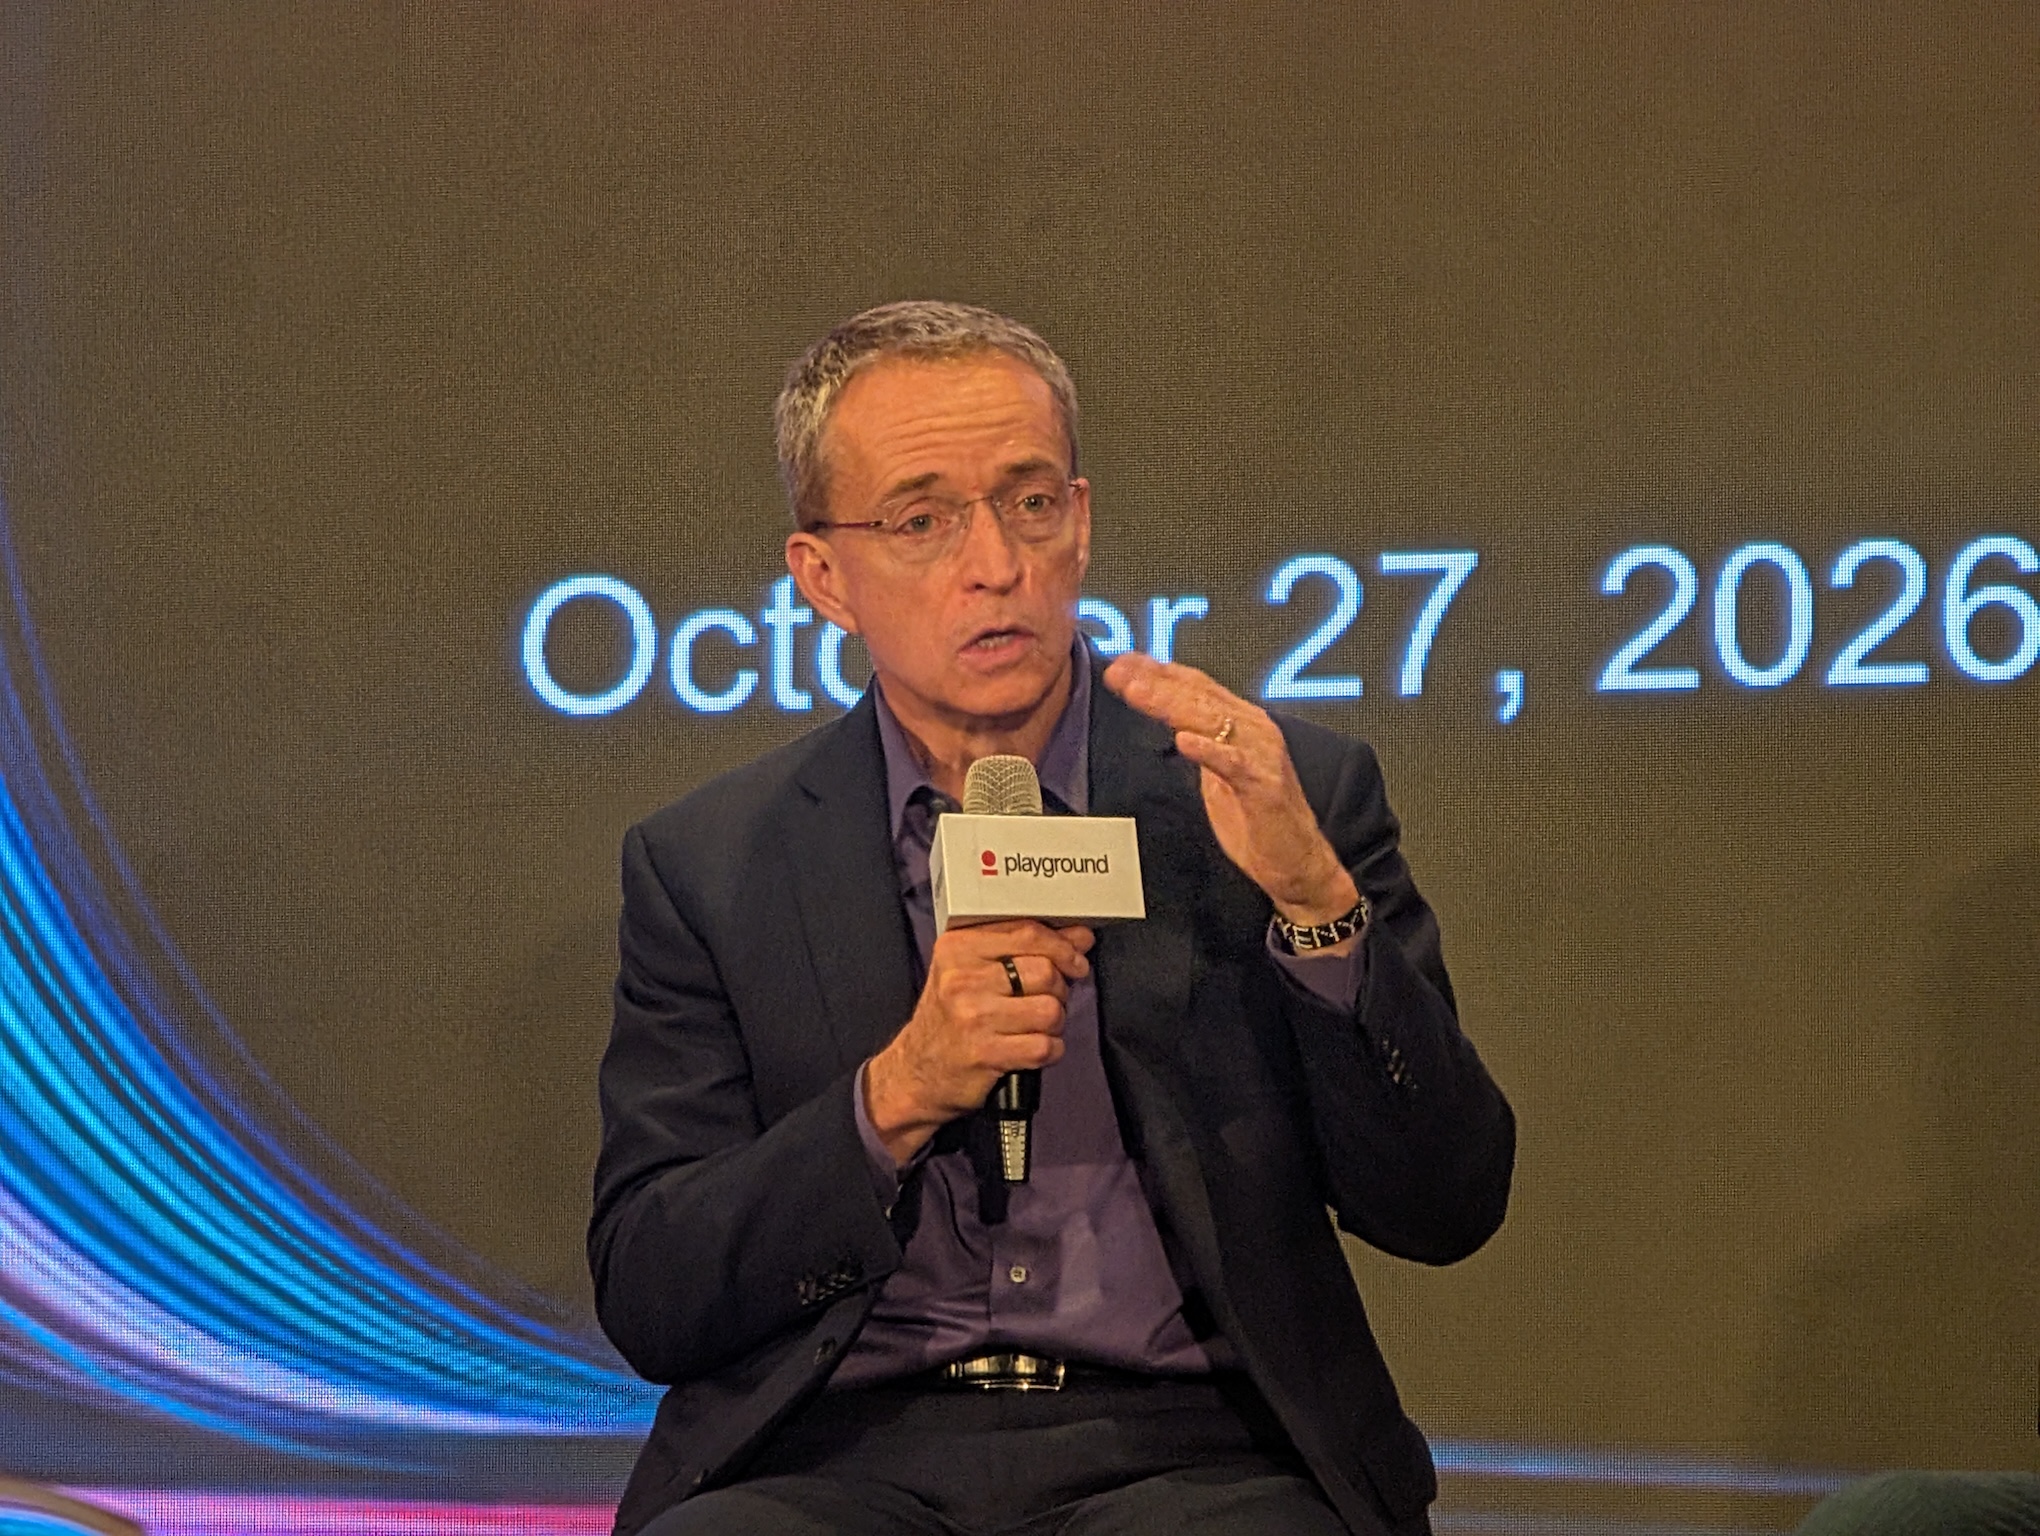
如果未來 AI 的應用規模成長 1 萬倍,支撐 AI 運算的電力、記憶體和晶圓廠產能,也能跟著增加 1 萬倍嗎?Intel 前執行長、現任深科技創投 Playground Global 合夥人 Pat Gelsinger(季辛格)在今(27 日)舉辦的台灣記者會上拋出這個問題,而他的答案是否定的。
季辛格認為,AI 將進一步進入日常生活、企業流程與製造現場,但支撐運算的實體資源不可能無限制擴張。他因此主張,未來必須讓 AI 的運算效率提升至少 1 萬倍,僅靠晶片或供電效率改善 10% 等漸進式進步,遠不足以滿足長期需求。
那麼,下一代運算該從哪些環節尋求突破?從季辛格所屬的深科技創投 Playground Global 今日在台展示的六家投資組合公司,或許可以看出一些方向。這些新創分別從記憶體、晶片供電、先進封裝與光學互連等環節切入,嘗試解決 AI 運算系統面臨的效率瓶頸。
AI 運算效率的瓶頸,不只在 GPU 算力
季辛格指出,AI 本質上高度依賴記憶體,雖然高頻寬記憶體(HBM)是當前 AI 加速器的重要技術,但其底層 DRAM 架構並非專為 AI 工作負載設計。Playground 投資的新創 Nagare Labs,便試圖從記憶體架構尋找解法。
Nagare Labs 提出名為 Z2RAM 的新型記憶體技術,採用雙電晶體、零電容(2T0C)架構,試圖兼顧 SRAM 的高速特性與 DRAM 的高密度優勢,並透過將記憶體直接堆疊在邏輯晶片上,降低 AI 推論過程中的資料搬移負擔。Nagare Labs 已取得 Playground 領投的 500 萬美元種子輪資金,計劃在未來一年朝 300 mm 晶圓製造階段推進,距離大規模商業化仍有工程挑戰。
除了記憶體存取,電力如何有效送進運算晶片,也是另一項問題。Playground 投資的 Powerlattice 將整合式電壓調節器(IVR)製作成小晶片,整合至處理器封裝內,以縮短供電路徑、減少損耗,並改善快速負載變化時的供電穩定性。Powerlattice 宣布,已在模擬下一代 AI 加速器負載變化的條件下,完成供電小晶片展示,並宣稱相關架構有望將運算功耗降低逾 50%。
先進封裝從配角變核心,季辛格估未來價值占比近半
當 AI 運算系統整合越來越多運算與記憶體元件,如何有效連接不同晶片,也成為重要挑戰。季辛格指出,如今 GPU、CPU 等系統可能整合 10 顆、12 顆,甚至 20 顆小晶片(Chiplet),使過去被視為後段環節的封裝,成為影響效能、功耗與成本的核心技術。他更預期,隨著未來多晶片架構發展,先進封裝可能占產品總價值近一半。
Playground 投資的 Syenta,便試圖改善高密度晶片互連的製程瓶頸。這家公司今日展示局部電化學製造(LEM)技術的整片晶圓製程成果,試圖將傳統金屬互連製造中的圖案製作與沉積整合,減少製程步驟。根據 Syenta,其技術已能在整片晶圓上進行局部銅沉積,並展示多層電路製作成果,未來希望延伸至面板級封裝。
當運算系統進一步擴展至多個機架,資料傳輸也面臨頻寬與功耗的限制。另一家新創 Ayar Labs 則透過光學互連技術,讓光訊號承擔高頻寬資料傳輸工作,改善傳統銅線互連的限制。Ayar Labs 此次宣布新竹辦公室正式啟用,台灣團隊目前約 10 人,未來一至兩年將持續擴編,深化與台灣晶圓代工及系統製造夥伴的合作。該公司近期募資規模達 6.5 億美元,投資人包括聯發科與緯穎。
對台灣半導體產業而言,這些技術能否進一步商業化,同樣離不開製造生態系。季辛格強調,台灣具備快速將技術概念轉化為原型、進一步推向規模化生產的能力。從 Nagare Labs 計劃進入 300 mm 晶圓製造階段,到 Ayar Labs 在新竹設點,反映出這些下一代運算技術與台灣供應鏈的連結正持續加深。
【推薦閱讀】
◆ 華為與 DeepSeek 聯手挑戰 NVIDIA,SemiAnalysis 實測:軟體接近前沿、硬體仍落後
*首圖來源:《TechOrange》拍攝