
機器人要完成拉拉鏈、開瓶蓋這類精細動作,觸覺不可或缺,但市面上的觸覺感測器還沒有主流規格,壓阻式、磁性、視覺觸覺各自輸出不同的訊號,彼此難以互通。螞蟻集團旗下的具身智慧(Embodied AI)公司 Robbyant(螞蟻靈波),於 11/10 開源觸覺基礎模型 LingBot-Touch,主打把不同感測器的訊號轉成統一表徵,讓不同的靈巧手與動作模型共用。
Robbyant 在技術報告中指出,在兩款靈巧手的 26 項任務中,四種動作模型(決定機器人如何動作的 AI 模型)接上 LingBot-Touch 後,平均成功率較不給觸覺時提升約 14 至 25 個百分點。對評估觸覺方案的團隊而言,換感測器就得重來的成本能否因此降低?證據又走到哪一步?
觸覺感測器沒有主流規格,訊號與資料為何難以跨硬體共用?
Robbyant 指出,商用觸覺感測器仍處於早期發展階段,各類感測器都有不可取代的優勢,也各有缺點。產業媒體《Fierce Sensors》同樣指出,觸覺感測目前還沒有主導性的架構;《Interesting Engineering》則認為,單一感測技術不太可能主導市場。
Robbyant 說明,同一個物理接觸,會因感測原理與觸點排列不同,產生不同的原始訊號;技術報告也形容,一種感測器的讀數,對以另一種感測器訓練的模型而言毫無意義。《Interesting Engineering》點出,開發者因此每換一次硬體,都得重新收集資料、重新訓練模型並調整系統。
資料規模也因此受限。研究團隊指出,不同感測器的資料無法合併,加上每小時的資料都要靠裝了感測器的手實際觸碰取得,目前沒有大型、經過整理的觸覺資料庫。研究團隊認為,這些問題的根源,在於觸覺資料綁定在產生它的感測器物理特性上。
那麼,直接把原始觸覺訊號接進動作模型是否可行?技術報告的實驗顯示成效有限:四種動作模型的平均增益約 7 至 11 個百分點,最多只有接上 LingBot-Touch 時的一半左右;在 104 組任務與動作模型的組合中,還有 22 組表現反而變差,例如 π0.5 做拉拉鏈任務的成功率從 39.0% 降到 15.0%。
一套模型讀三類感測器:LingBot-Touch 怎麼把觸覺轉成通用表徵?
LingBot-Touch 的預訓練資料共 4,983 小時,涵蓋磁性、視覺觸覺、壓阻式三類主流感測原理。其中約三分之二來自人戴觸覺手套收集,其餘三分之一來自遙控操作,也就是由人遠端操控裝有 Sharpa Wave 靈巧手的雙臂系統。
在做法上,研究團隊先把每種感測器的觸覺像素(taxel,觸覺感測器上的單一感測點)對應到共同的標準指尖座標空間(canonical fingertip space),三類感測器各用一個分詞器(tokenizer)處理,再以 Tactile-JEPA 方法訓練編碼器(JEPA 為聯合嵌入預測架構,Joint-Embedding Predictive Architecture),從部分可見的觸覺片段,在潛在空間(latent space)預測完整片段的表徵。訓練出的觸覺 token(模型處理的資料單位)可以隨插即用,接進不同的動作模型。
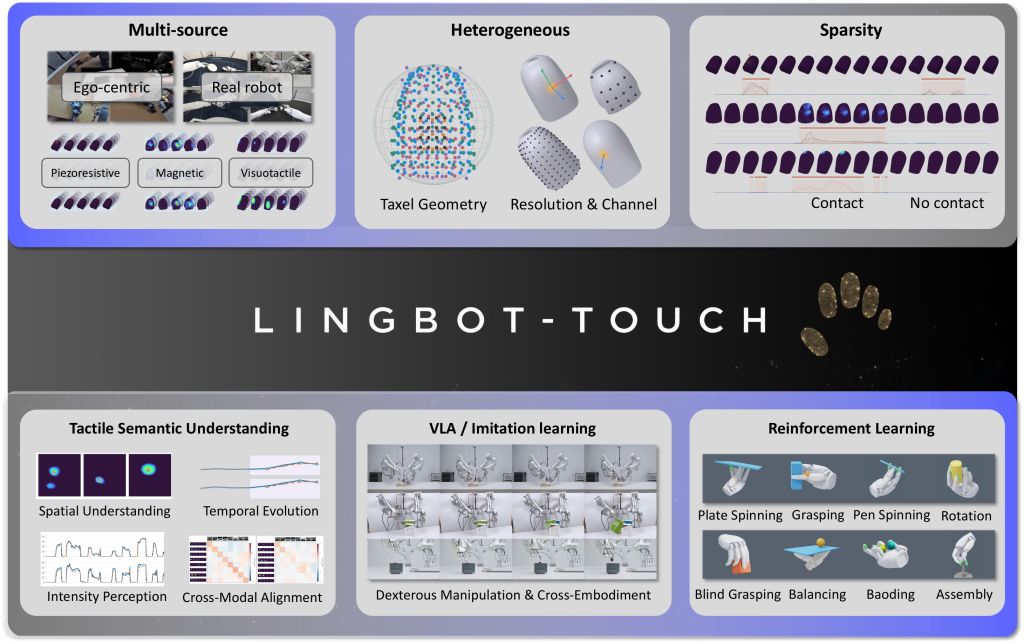
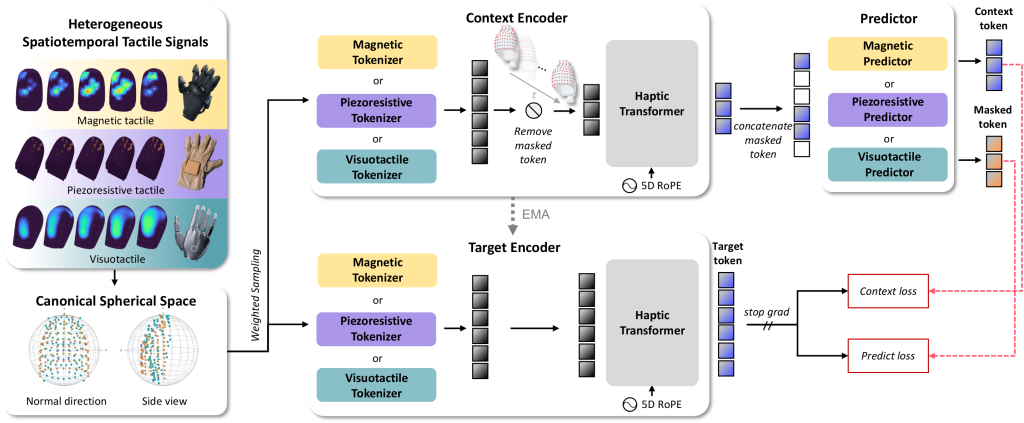
前述約 14 至 25 個百分點的提升,是 Diffusion Policy、π0.5、LingBot-VLA、T-Rex 四種動作模型,在 Sharpa Wave 20 項、XHand1 6 項,共 26 項真實機器人任務的平均結果,每項連續試 20 次。實驗全部使用以約 4,000 小時資料預訓練的 Tiny 版,技術報告標示其參數量為 546 萬,接上 T-Rex、π0.5、LingBot-VLA 後,整體參數只增加 0.13% 至 0.16%。
不過,LingBot-Touch 並非每組都勝出:在 104 組組合中,它有 89 組是三種設定(不給觸覺、給原始訊號、給 LingBot-Touch)中最好的,99 組不低於原始動作模型;但也有 9 組低於直接給原始訊號,另有 5 組低於原始動作模型。
跨硬體的測試放在 XHand1 上。這款手的磁性指尖感測器型號不在預訓練資料中,模型的磁性觸覺經驗全來自人戴手套的資料;團隊凍結 LingBot-Touch 的參數、不為新感測器更新分詞器或編碼器,只用 XHand1 的示範資料訓練動作模型。
結果,同樣的訊號直接輸入時,四種動作模型的平均成功率變化只在 −1.7 至 +4.6 個百分點之間;改用 LingBot-Touch 後,則較原始動作模型提升 13.8 至 24.5 個百分點。研究團隊稱,觸覺模型本身無須重新訓練,就能用於未見過的同類感測器型號,但動作模型仍需以新硬體的示範資料訓練。
數據自報、以指尖為主:LingBot-Touch 和 Meta Sparsh 等前例有何不同?
統一觸覺表徵並非全新方向。Meta 先前開源的 Sparsh,被該公司稱為第一個用於視覺觸覺感測的通用編碼器,以不需人工標註的自監督學習、超過 46 萬張觸覺影像預訓練,可用於多種視覺觸覺感測器。技術報告也列出 Sparsh-skin、Sparsh-X 等相關研究,分別處理磁性觸覺,以及整合影像、聲音、動作與壓力訊號。
技術報告認為最接近的前例,是同樣為異質感測器設計、也有磁性分支的 FTP-1。兩者的差別在於,FTP-1 透過各感測器專屬的編碼器支援新硬體,LingBot-Touch 則依三類感測原理各用一個分詞器、共用同一個編碼器。研究團隊稱,在未見過的 XHand1 感測器上,不加轉接層的 LingBot-Touch,在五項探測任務(從觸覺特徵判讀接觸力、位置等資訊的測試)上都勝過加裝專屬轉接層的 FTP-1。
至於限制,研究團隊在技術報告中列出,還需要在更多款機械手上做真實與模擬實驗;預訓練目前沒有電容式感測器,因為取得的資料未達品質要求;標準座標與預訓練布局也以指尖為主,手掌與手指其他部位的接觸代表性不足。此外,26 項任務是挑選過、觸覺會有影響的任務,跨硬體也只驗證了一款未見過的磁性感測器型號。
開放也有條件。目前 GitHub 已釋出推論用的凍結編碼器程式碼、Sharpa Wave 與 XHand1 各 30 組雙手範例輸入資料,以及 Tiny、Small 兩版權重;權重放在 Hugging Face 與 ModelScope,下載需取得模型儲存庫的存取權限,程式碼採 Apache 2.0 授權。近 5,000 小時的預訓練資料則目前未見釋出。上述成效數據都是公司自報,目前未見第三方複現。
LingBot-Touch 也是 Robbyant 今年陸續開源 LingBot 系列的延伸,此前已開源視覺-語言-動作(VLA)模型 LingBot-VLA、世界模型 LingBot-World,以及 VLA、World 等模型的 2.0 版。根據《The Next Web》分析,中國有超過 100 家人形機器人廠商,多數做身體而非大腦,誰提供大腦,就會成為其他業者建構的基礎層。觸覺模型能否在更多款機械手與第三方測試中站穩,仍有待驗證。
【推薦閱讀】
◆ 中國機器人競爭轉向 AI「大腦」:為何連訓練資料新創都募得 1 億美元?
◆ 機器人不一定要有五指靈巧手,Zinova 提出「工具智慧」概念開拓建築機器人新方向
◆ 金融科技巨頭為何做起人形機器人?馬雲撐腰的螞蟻集團推首款人形機器人 R1
*本文開放合作夥伴轉載,資料來源:Robbyant 1、Robbyant 2、Robbyant 3、Robbyant 4、Robbyant 5、Robbyant 6、Meta、《Interesting Engineering》、《The Next Web》、《Fierce Sensors》,首圖來源:Robbyant